Sentieon
Sentieon 中文手册
Sentieon 中文手册(上册)
Sentieon 中文手册(下册)
Sentieon 软件应用教程
Sentieon | 联合Dell、AMD开发基因组大数据分析加速方案
Sentieon | 应用教程: 利用Sentieon Python API引擎为自研算法加速
Sentieon | 应用教程: 关于读段组的建议
Sentieon | 应用教程: 使用DNAscope对HiFi长读长数据进行胚系变异检测分析
Sentieon | 应用教程: TNscope® 使用机器学习模型进行有匹配正常样本的体细胞变异发现
Sentieon | 应用教程: CCDG使用Sentieon®的功能等效流程
Sentieon | 应用教程: 利用共识功能去除PCR重复
Sentieon | 应用教程: 适用于PacBio HiFi和Oxford Nanopore长读长测序数据的结构变异检测
Sentieon | 应用教程: 使用 Sentieon进行大型基因组重测序分析
Sentieon | 应用教程: 体细胞SNP/Indel变异检测
Sentieon | 应用教程: DNAscope使用机器学习模型进行胚系变异调用
Sentieon | 应用教程: 唯一分子标识符(UMI)
Sentieon | 应用教程: Sentieon分布模式
Sentieon | 应用教程:使用CNVscope进行CNV检测分析
Sentieon发布核心家系(trio)基因分析最佳实践方案
Sentieon推出Segdup-caller:针对片段重复区域的专用精准变异检测工具
Sentieon-cli | DNAscope WES 流程单条命令版本详解
Sentieon | DNAscope 核心家系(trio) WES 分析全流程详解
Sentieon | DNAscope Hybrid长短读长混合分析流程详解及评测
Sentieon | DNAscope LongRead:面向ONT WGS的快速、高精度、低成本变异检测流程
重磅发布|真迈生物联合Sentieon打造SURFSeq 5000 CMS + DNAscope工作流
Sentieon软件版本更新
Sentieon | 发布V202503.01版本
Sentieon | 发布V202503.02版本
Sentieon | 发布V202503.03版本
Sentieon | 发布V202503.04版本
Sentieon软件快速入门指南
Sentieon 软件模块总述
Sentieon 特色流程 - DNAscope
Sentieon | DNAscope Illumina 流程
sentieon | DNAscope Complete Genomics 流程
Sentieon | DNAscope LongRead PacBio 流程
Sentieon | DNAscope Ultima Genomics 流程
Sentieon | DNAscope Element Bio 流程
Sentieon | DNAscope LongRead Nanopore 流程
Sentieon混合分析流程 - DNAscope Hybrid
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(上)
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(下)
毅硕Sentieon | 泛基因组分析流程详解
Sentieon | 基于Illumina WGS数据的高精度、低成本的泛基因组分析方案
Sentieon | 基于Ultima WGS数据的高精度、低成本的泛基因组分析测评
Sentieon | 泛基因组分析流程详解—CHM13 (T2T) 更新版
Sentieon | DNAscope Pangenome:赋能人类高精度生殖筛查
Sentieon|植物泛基因组分析加速详解
毅硕Sentieon | RNA-seq 变异检测全流程详解
毅硕Sentieon | 物种全基因组(WGS)分析流程
毅硕Sentieon | 植物全基因组(WGS)分析流程
毅硕Sentieon | 小麦(Triticum aestivum)全基因组WGS分析流程
毅硕Sentieon | 水稻(Oryza sativa)全基因组WGS分析流程
毅硕Sentieon | 拟南芥(Arabidopsis thaliana)全基因组WGS分析流程
毅硕Sentieon | 马铃薯(Solanum tuberosum)全基因组WGS分析流程
毅硕Sentieon | 巨桉(Eucalyptus grandis)全基因组WGS分析流程
毅硕Sentieon | 向日葵(Helianthus annuus)全基因组WGS分析流程
毅硕Sentieon | 野草莓(Fragaria vesca)全基因组WGS分析流程
毅硕Sentieon | 银杏(Ginkgo biloba)全基因组WGS分析流程
毅硕Sentieon | 大豆(Glycine max)全基因组WGS分析流程
毅硕Sentieon | 陆地棉(Gossypium hirsutum)全基因组WGS分析流程
毅硕Sentieon | 胡桃(Juglans regia)全基因组WGS分析流程
毅硕Sentieon | 苹果(Malus domestica)全基因组WGS分析流程
毅硕Sentieon | 香蕉(musa acuminata)全基因组WGS分析流程
毅硕Sentieon | 罂粟(Papaver somniferum)全基因组WGS分析流程
毅硕Sentieon | 开心果(Pistacia vera)全基因组WGS分析流程
毅硕Sentieon | 毛果杨(Populus trichocarpa)全基因组WGS分析流程
毅硕Sentieon | 夏栎(Quercus robur)全基因组WGS分析流程
毅硕Sentieon | 油棕(Elaeis guineensis)全基因组WGS分析流程
毅硕Sentieon | 高粱(Sorghum bicolor)全基因组WGS分析流程
毅硕Sentieon | 玉米(Zea mays)全基因组WGS分析流程
毅硕Sentieon | 动物全基因组(WGS)分析流程
毅硕Sentieon | 猪(sus scrofa)全基因组WGS分析流程
毅硕Sentieon | 鸡(Gallus gallus)全基因组WGS分析流程
毅硕Sentieon | 家鼠(Mus musculus)全基因组WGS分析流程
毅硕Sentieon | 家犬(canis lupus familiaris)全基因组WGS分析流程
毅硕Sentieon | 东方蜜蜂(Apis cerana)全基因组WGS分析流程
毅硕Sentieon | 电鳗(Electrophorus electricus)全基因组WGS分析流程
毅硕Sentieon | 红隼(Falco tinnunculus)全基因组WGS分析流程
毅硕Sentieon | 家猫(Felis catus)全基因组WGS分析流程
毅硕Sentieon | 尼罗罗非鱼(Oreochromis niloticus)全基因组WGS分析流程
毅硕Sentieon | 狮子(Panthera leo)全基因组WGS分析流程
毅硕Sentieon | 东北虎(panthera tigris altaica)全基因组WGS分析流程
毅硕Sentieon | 黑猩猩(pan troglodytes)全基因组WGS分析流程
毅硕Sentieon | 中国鳖(pelodiscus sinensis)全基因组WGS分析流程
毅硕Sentieon | 褐家鼠(rattus norvegicus)全基因组WGS分析流程
毅硕Sentieon | 家牛(Bos taurus)全基因WGS分析流程
毅硕Sentieon | 虎河豚(takifugu rubripes)全基因WGS分析流程
毅硕Sentieon | 人类(Homo sapiens)全基因组WGS分析流程
毅硕Sentieon | 狮尾狒(theropithecus gelada)全基因组WGS分析流程
毅硕Sentieon | 草鱼(Ctenopharyngodon idella)全基因组WGS分析流程
毅硕Sentieon | 绵羊(Ovis aries)全基因组WGS分析流程
毅硕Sentieon | 北极熊(ursus maritimus)全基因组WGS分析流程
毅硕Sentieon文献解读
Sentieon文献解读 | Population Sequencing
Sentieon文献解读 | Agrigenomics
Sentieon | Agrigenomics-泛基因组揭示小麦结构变异与栖息地及育种的关联
Sentieon文献解读 | Genetic Disease
Sentieon文献解读 | Tumor Sequencing
Sentieon文献解读 | Benchmark and Method Study
Sentieon文献解读 | Long Read Sequencing
Sentieon文献解读 | Clinical Trial
Sentieon文献解读 | Epidemiology
Sentieon文献解读 | Gene Editing
Sentieon文献解读 | Liquid Biopsy
Sentieon | TNscope 分析流程详解
Sentieon | TNscope WES Panel 分析流程详解
-
+
home
Sentieon | Agrigenomics-泛基因组揭示小麦结构变异与栖息地及育种的关联
# 引言 *普通小麦(AABBDD)源于7000-8000年前中东地区四倍体小麦与粗山羊草的自然杂交。约3500-4000年前传入中国,逐渐成为华北主要农作物。* *自1950年以来,我国共育成审定约3500个小麦新品种。多样化的生态类型(如春性与冬性、雨养与灌溉、单季与双季)和复杂的饮食文化需求,共同驱动了中国小麦遗传多样性的形成与演变。* *研究团队选取17个具有代表性的品种进行基因组测序,结合现有的泛基因组资源,识别出大量结构变异。**在基因数据分析过程中,研究团队使用Sentieon DNAseq进行变异检测,大幅提升了大数据分析的准确性和效率。*** *分析显示欧洲种质在中国现代小麦育种中的整合过程,以及VRN-A1等重要基因的进化特征。在CM42中发现的外源片段和1RS·1BL易位体中pSc200的显著减少,反映了小麦基因组的持续进化 。*  本周的Sentieon文献解读专栏给大家带来一篇被引用高达50次的佳作:“Pan-genome bridges wheat structural variations with habitat and breeding”,该文章于2024年在《Article》发表,由中国农业科学院作物科学研究所联合南京农业大学、澳大利亚莫道克大学等机构共同完成。 解读文章,给做进化育种的老师学生们一些参考。 --- # 材料与方法学 ## 研究材料 17个品种:BJ8、MZM、XN6028、Abo、NC4、YM158、XY6、AMN、JM47、S4185、CM42、JM22、KF11、ZM366、ZM16、ZM22、HD6172; ## 研究方法 **基因组测序与组装方法** 研究团队首先使用PacBio Sequel II平台对17个小麦品种进行长读长测序,构建15-kb SMRT Bell文库,平均深度为30.37X。并利用Hi-C技术对交联的染色质进行DpnII酶切、生物素标记和连接并建库,使用Illumina NovaSeq 6000进行双端测序,平均深度为63.82X。 在基因组组装过程中,使用Hifiasm进行contig组装,结合ALLHiC和Hi-C数据聚类,用Juicebox进行人工校正。 **转录组分析与基因注释** 转录组分析涵盖四个品种(XY6、AMN、JM22、ZM16)的8个组织,使用DNBSEQ-T7进行测序,每个样本获得约10 Gb数据。并进行PacBio Iso-seq测序,构建0-5 kb插入文库,在Sequel II上获得超过10 Gb的测序数据。 基因注释过程包括三个主要方面:重复序列注释、基因结构预测和功能注释。 重复序列注释整合了ClariTeRep和TREP-DB数据库,使用RepeatMasker和Tandem Repeats Finder进行分析。 基因结构预测则综合了同源预测、从头预测和转录本证据,通过EvidenceModeler进行整合。 功能注释通过比对NCBI-NR等五大数据库完成,并使用InterProScan进行蛋白结构域和GO注释。 **变异检测与群体分析** 变异检测包括SNP/InDel和结构变异(SV)的鉴定。SNP/InDel鉴定使用BWA-MEM进行比对,经过SAMtools去除重复,使用Sentieon DNAseq进行变异检测,由GATK进行过滤。使用MUMmer和SyRI进行SV鉴定。 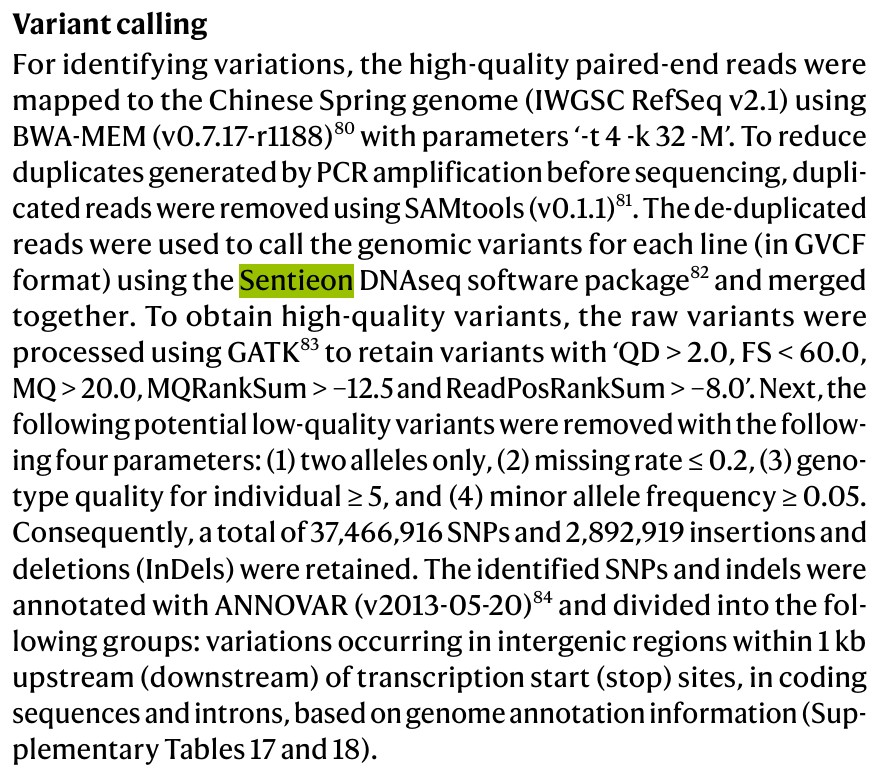 多样性分析整合了145个重测序品种数据,通过t-SNE分析构建种质网络,使用VCFtools计算遗传分化指数。GWAS分析采用EMMAX模型对生态型和籽粒硬度等性状进行研究,显著性阈值设为P<1×10⁻⁵。 最后,通过系统发育分析和细胞遗传学验证进一步确认研究结果。系统发育分析使用MAFFT和FastTree构建VRN-A1基因的进化树,细胞遗传学验证则通过FISH/GISH技术,使用特异性探针在ZEISS Imager Z2显微镜下进行观察。 --- # 研究结果 **基因组组装与泛基因组特征** 研究选择了17个代表中国70年育种历史的普通小麦品种,覆盖不同育种阶段的品系:1950-1960年代、1980-1990年代和2000年后。测序获得最终组装大小平均14.86 Gb。平均contig N50达27.36 Mb,97.38%的contigs被定位到染色体上,BUSCO完整性超过98.90%,每个品种平均识别出约153,077个蛋白编码基因。 整合21个基因组组装进行泛基因组分析,识别出170,517个潜在基因家族,其中111,955个为核心基因家族。NLR基因分析显示,1980-1990年代品种具有最高的NLR基因数量,且NLR基因集在亚基因组水平上显示未饱和,表明具有高度动态的存在/缺失变异特征,在未来小麦育种中仍有发现新的抗病基因的可能。 通过与中国春小麦参考基因组比较,识别出249,976个结构变异,包括存在/缺失变异、易位和倒位。结构变异从老品种到新品种呈增加趋势。B亚基因组显示最高的PAV积累水平。多维分析显示1950和1980年代品种间存在明显分离,而2000年代后的品种显示出与欧洲多样性的整合特征。 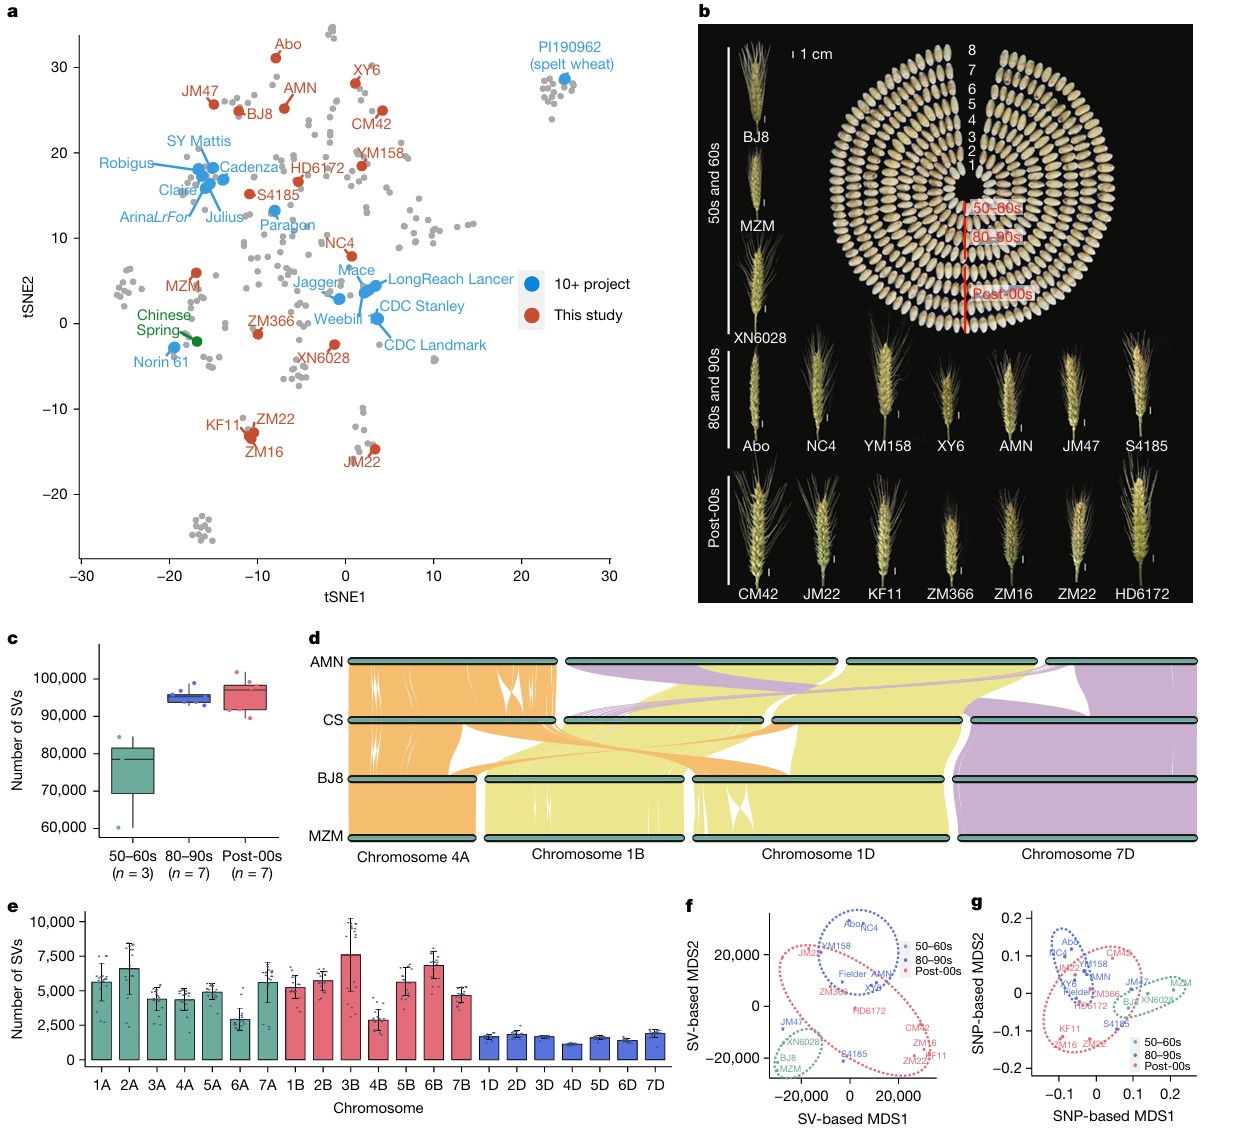 *图2 17个小麦品种的穗部和种子、基因组组装以及对当地和全球小麦多样性的代表性 a. 基于来自三个先前研究的285个全球代表性种质(灰色)、10+基因组测序项目的15个品系(蓝色)、中国春(绿色)和新组装基因组(红色)的全基因组重测序SNPs数据进行的t-分布随机邻居嵌入(tSNE)分析。 b. 17个品种的穗部和种子表型。 c. 三个时期发布的品种间结构变异(SVs)数量的箱线图。 d. 小麦品种中的大型结构易位。在AMN和中国春(CS)之间观察到1B染色体和7D染色体之间的易位,而BJ8和MZM相对于中国春在4A染色体和1D染色体之间共享一个共同的易位区域。 e. 21条染色体中存在/缺失变异(PAVs)的数量。 f,g. 基于结构变异(SVs)(f)和单核苷酸多态性(SNPs)(g)的多维尺度分析(MDS)揭示的从头组装小麦品种间的遗传关系。* **结构变异的功能与演化机制** 研究团队通过分析145个重测序品种的交叉重组数发现,染色体核心着丝粒区域存在大量PAV,这些结构变异的积累与重组减少和染色体着丝粒区域单倍型块的形成密切相关。 在着丝粒祖先单倍型组(centAHG)分析中,组间在着丝粒近端区域表现出较高的结构变异频率,而组内较低。这种变异模式解释了不同野生二粒小麦谱系在着丝粒近端区域的低重组率,并在三个亚基因组间表现出显著的差异。 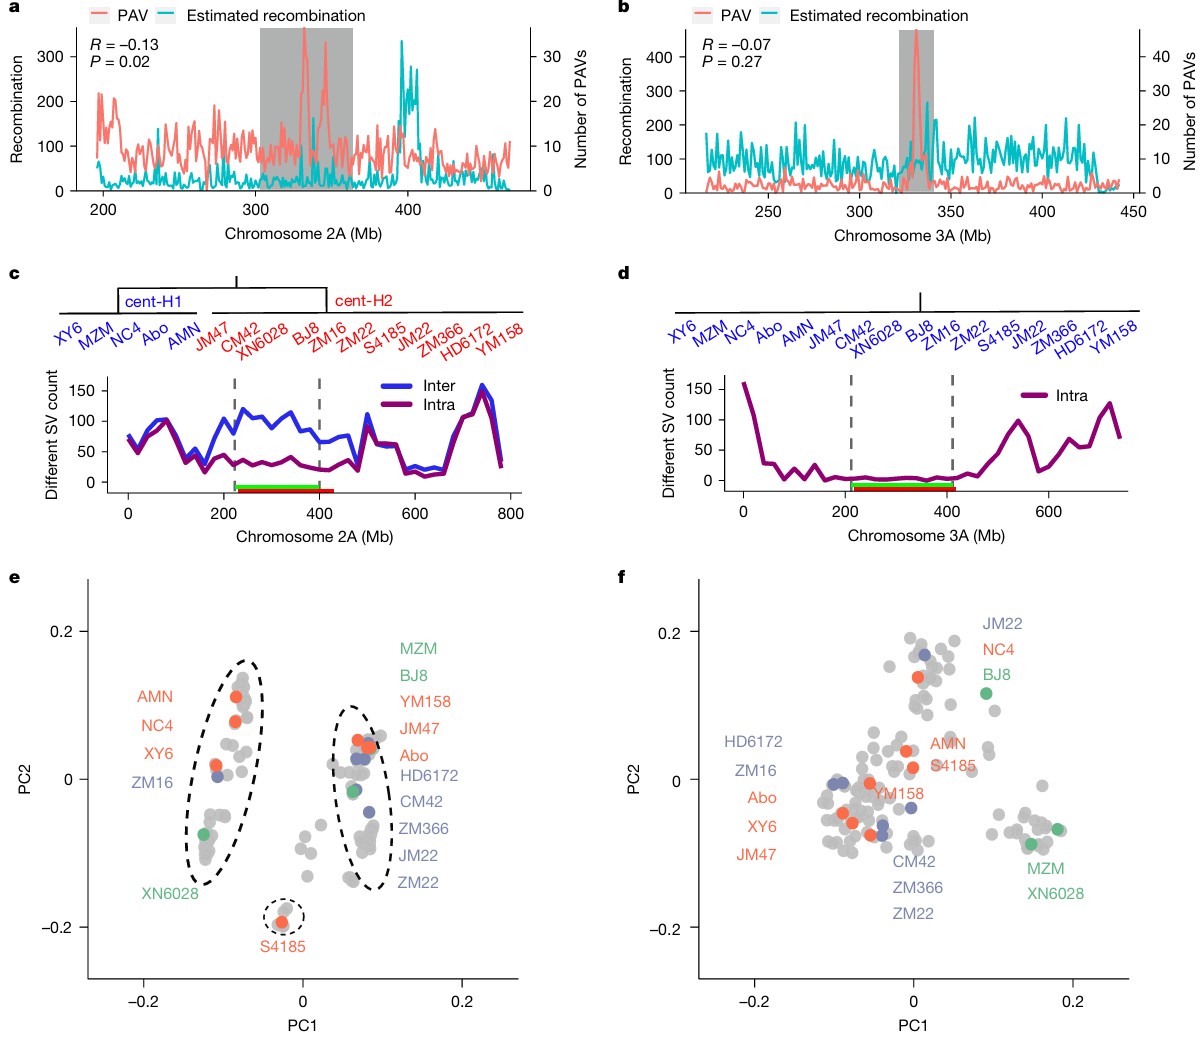 *图3 着丝粒近端区域的存在/缺失变异(PAVs)阻止了交叉重组 a,b. 在2A染色体(a)和3A染色体(b)上,着丝粒上游和下游100 Mb范围内(灰色阴影区域)的交叉重组数(CRN)与PAV数量的相关性。 c. 在17个从头组装的基因组中,2A染色体的两个着丝粒单倍型组(centAHGs)被分为cent-H1和cent-H2两组(上图)。下图显示了2A染色体上组内centAHG(紫色)和组间centAHG(蓝色)之间不同结构变异(SVs)的数量。红色条带表示着丝粒上下游各100 Mb的着丝粒近端区域。绿色条带表示先前确定的centAHG区块。 d. 在17个从头组装的基因组中,3A染色体上只检测到一个centAHG。 e,f. 基于2A染色体(e)和3A染色体(f)着丝粒上下游100 Mb范围内的结构变异(SVs)对145个标志性品种重测序数据进行的主成分分析(PCA)。绿色散点代表1950-1960年代发布的品种;橙色散点代表1980-1990年代发布的品种;蓝色散点代表2000年后发布的品种;灰色散点代表其他品种。* **关键基因的适应性演化** 研究发现VRN-A1基因在育种过程中经历了重要的结构变异。基于CDS区域的SNP分析将VRN-A1基因单倍型分为一个春性和两个冬性类群。研究显示VRN-A1的拷贝数与生态型相关,强冬性品种比冬性和春性品种具有更多拷贝数,也有更高的转录水平。随着小麦从中东向中国传播,VRN-A1拷贝数增加,但在过去70年中国北方现代品种中逐渐减少,表明与气候变暖有关。 在籽粒硬度方面,研究识别出Pina的两个等位基因(Pina-D1a和Pina-D1b)和Pinb的三个等位基因(Pinb-D1a、Pinb-D1b和Pinb-D1u)。 中国品种表现出更高的等位基因多样性,且PIN基因的地理分布与当地饮食习惯密切相关。在中国南方,为适应蒸煮食品的需求,选择了携带野生型等位基因的软质小麦品种; 而在北方,尤其是少数民族地区,则更多选择携带突变等位基因的硬质小麦品种,这与西方烘烤式的食物制备方式相似。 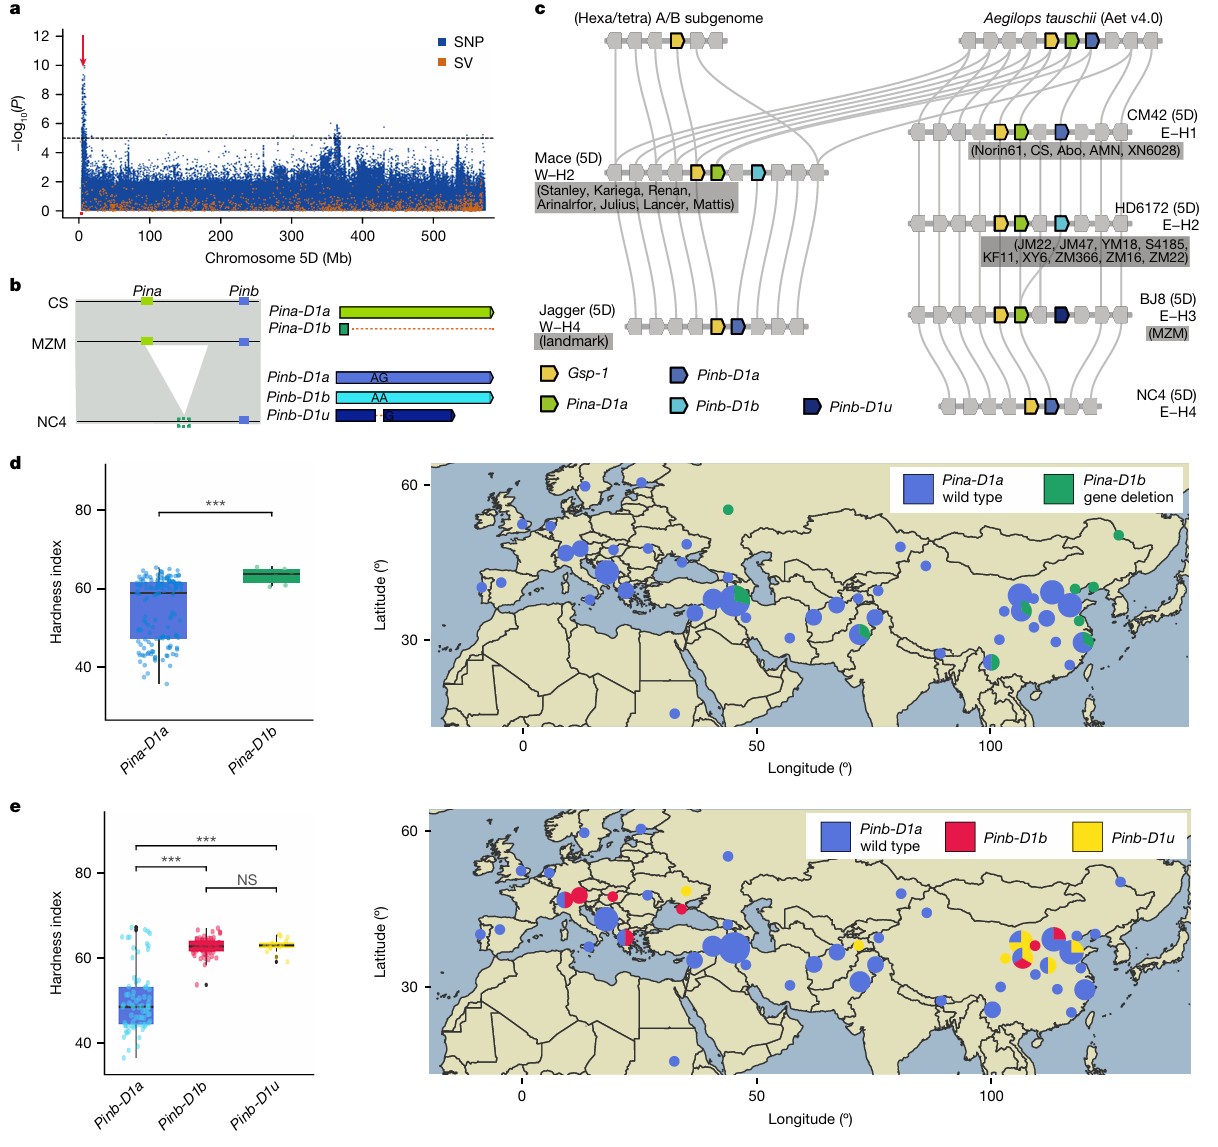 *图4 Pina和Pinb基因的等位基因比较及其在地方品种中的地理分布显示中国南北食品文化对籽粒硬度的不同偏好 a. 145个标志性品种籽粒硬度的GWAS曼哈顿图。箭头标注的显著关联位点代表待进一步研究的Pina-D1或Pinb-D1基因。 b. 在10+泛基因组和17个新组装基因组中发现的Pina-D1和Pinb-D1等位基因。左侧面板显示硬度(Ha)位点的共线性模式,其中绿色和蓝色条带分别代表Pina和Pinb。右侧面板展示了这些等位基因的转录本结构,包括Pina-D1基因的Pina-D1a(野生型)和Pina-D1b(基因缺失),以及Pinb-D1基因的Pinb-D1a(野生型)、Pinb-D1b和Pinb-D1u。 c. 不同组装基因组间Ha位点的微观共线性分析。实心五边形代表编码基因。灰色线表示基因直系同源关系。 d,e. 地方品种中Pina-D1和Pinb-D1的单倍型图(右)以及Ha位点不同单倍型的籽粒硬度箱线图(左)。蓝色代表野生型Pin基因。绿色、红色和黄色分别代表Pina-D1b、Pinb-D1b和Pinb-D1u。P < 0.001,NS表示差异不显著。地图使用R语言的sf和ggplot2包绘制。* **1RS染色体易位的快速进化** 由于1RS·1BL易位与较高产量以及对白粉病和条锈病的良好抗性相关,在中国获得广泛应用,约45%的商业化品种具有这种易位。通过从头组装的1RS序列分析,识别出1RS着丝粒周围的一个共线性缺失区域和四个高读取深度区域,以及1BL上的一个相关倒位。基于这些特征,1RS·1BL易位可分为四种单倍型。 1RS序列又可分为三个亚组。1RS序列表现出显著的异质性,同时具有增产效应和有利的根系性状,这解释了其在育种中被持续应用。 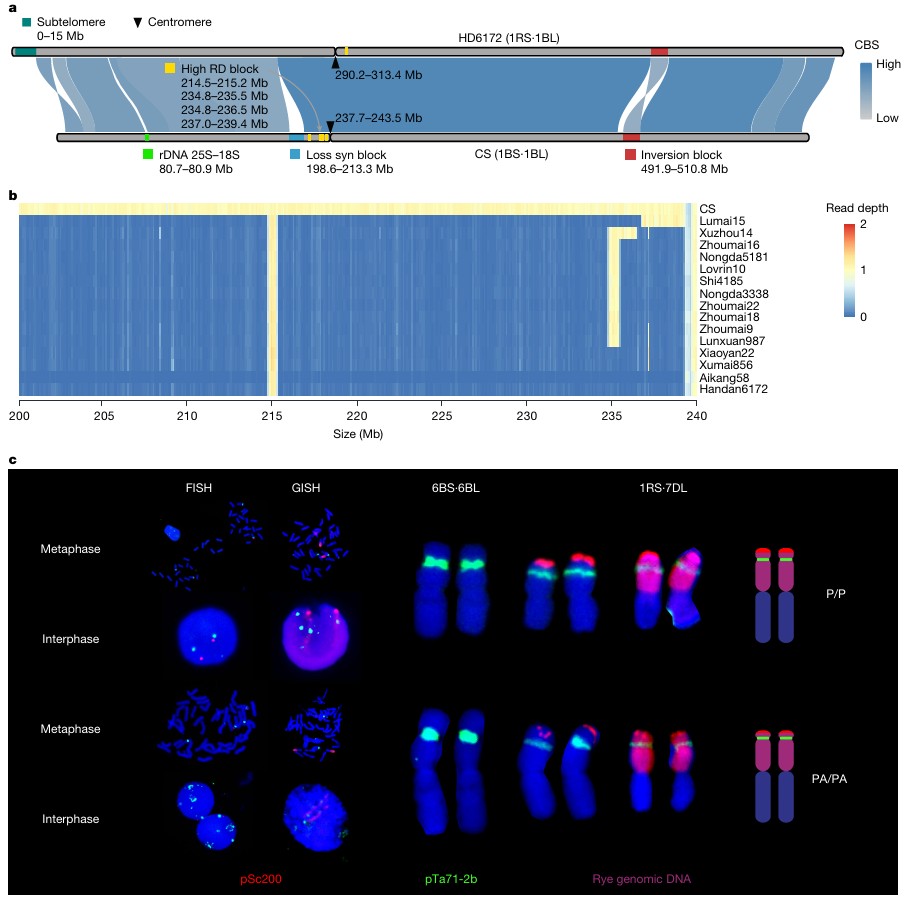 *图5 过去半个世纪小麦染色体上1RS易位的快速重组 a. HD6172中从头组装的1RS·1BL与中国春1B染色体之间的共线性分析。蓝色条带表示共线性(syn)缺失区域(198.6-213.3 Mb);黄色条带表示1BS上四个高测序深度区域(测序深度=1);红色条带代表1BL上与1RS·1BL相关的倒位;深绿色条带表示1RS的亚端粒序列;浅绿色条带代表rDNA(25S-18S);黑色三角形标记着着丝粒的位置。CBS表示共线性块得分。 黑麦基因组DNA,P/P:存在/存在;PA/PA:部分缺失/部分缺失; b. 1RS·1BL品种着丝粒区域(200.0-240.0 Mb)的测序深度热图。参照中国春1B染色体(IWGSC RefSeq v1.1),在1RS·1BL品种中检测到四个高测序深度区域(214.5-215.2 Mb、234.8-235.5 Mb、234.8-236.5 Mb和237.0-239.4 Mb)。 c. DNA重复序列的多色FISH检测在AMN的1RS端粒区域发现pSc200的大片段存在/缺失变异。端部的pSc200信号呈红色,NOR(pTa71-2b)呈绿色,1RS呈粉色。P表示存在;PA表示部分缺失。* **野生种质渗入的应用潜力** 在粗山羊草渗入方面,研究以CM42为例,发现其与中国春相比在3D和4D染色体上存在两个大的渗入片段,以及在1D、2D和7D染色体上的几个中等大小渗入片段。CM42不仅作为主要品种被广泛种植,还在中国西南地区育种中被用作新的创始基因型,表明渗入片段未对育种造成不利影响,同时证实了粗山羊草在小麦育种中的重要潜力。 --- # 研究讨论 **泛基因组与地理分化** 小麦在欧亚大陆传播过程中,通过野生四倍体小麦的遗传渗入,在A和B亚基因组中积累了地理特异性的结构变异。后续育种过程中的杂交促进了这些变异的整合。 **着丝粒区域变异** 着丝粒区域的DNA修饰和特殊蛋白的存在抑制了交叉重组。研究发现品种间的PAV与重组减少相关,主要因为野生二粒小麦的渗入和转座子的插入。 **春化基因进化** VRN-A1基因的拷贝数变异和单倍型分化反映了小麦对环境的适应过程。春性品种保留了古老单倍型,而冬性品种具有后期积累的单倍型,这种差异有助于小麦适应不同季节的种植。 **硬度与地域的关系** 籽粒硬度基因体现了地域性选择差异,特别是在中国南北方和欧洲地区。特定的Pina缺失与区域饮食传统密切相关。 **1RS易位进化** 1RS·1BL易位体中pSc200重复序列的PAV表明其正在进行快速进化,同时也证实了粗山羊草在育种中的重要价值。 --- # 研究总结 研究发现结构变异SV通过抑制着丝粒区域的重组过程,成为驱动小麦演化的重要机制。阐明了VRN-A1复制和食物文化共同塑造了小麦品种生态适应性。研究为优化育种策略提供了理论依据,有助于提高育种效率。还搭建了系统的基因组研究平台,为小麦分子育种提供重要的技术支持和资源保障。
chsnp
Nov. 7, 2025, 5:21 p.m.
Forward
Favorites
Last
Next
Scan the QR Code
Copy link
Scan the QR code to share.
Copy link
share
link
type
password
Update password
Validity period
Markdown file
Word document
PDF document (print)