Sentieon
Sentieon 中文手册
Sentieon 中文手册(上册)
Sentieon 中文手册(下册)
Sentieon 软件应用教程
Sentieon | 联合Dell、AMD开发基因组大数据分析加速方案
Sentieon | 应用教程: 利用Sentieon Python API引擎为自研算法加速
Sentieon | 应用教程: 关于读段组的建议
Sentieon | 应用教程: 使用DNAscope对HiFi长读长数据进行胚系变异检测分析
Sentieon | 应用教程: TNscope® 使用机器学习模型进行有匹配正常样本的体细胞变异发现
Sentieon | 应用教程: CCDG使用Sentieon®的功能等效流程
Sentieon | 应用教程: 利用共识功能去除PCR重复
Sentieon | 应用教程: 适用于PacBio HiFi和Oxford Nanopore长读长测序数据的结构变异检测
Sentieon | 应用教程: 使用 Sentieon进行大型基因组重测序分析
Sentieon | 应用教程: 体细胞SNP/Indel变异检测
Sentieon | 应用教程: DNAscope使用机器学习模型进行胚系变异调用
Sentieon | 应用教程: 唯一分子标识符(UMI)
Sentieon | 应用教程: Sentieon分布模式
Sentieon | 应用教程:使用CNVscope进行CNV检测分析
Sentieon发布核心家系(trio)基因分析最佳实践方案
Sentieon推出Segdup-caller:针对片段重复区域的专用精准变异检测工具
Sentieon-cli | DNAscope WES 流程单条命令版本详解
Sentieon | DNAscope 核心家系(trio) WES 分析全流程详解
Sentieon | DNAscope Hybrid长短读长混合分析流程详解及评测
Sentieon | DNAscope LongRead:面向ONT WGS的快速、高精度、低成本变异检测流程
重磅发布|真迈生物联合Sentieon打造SURFSeq 5000 CMS + DNAscope工作流
Sentieon软件版本更新
Sentieon | 发布V202503.01版本
Sentieon | 发布V202503.02版本
Sentieon | 发布V202503.03版本
Sentieon | 发布V202503.04版本
Sentieon软件快速入门指南
Sentieon 软件模块总述
Sentieon 特色流程 - DNAscope
Sentieon | DNAscope Illumina 流程
sentieon | DNAscope Complete Genomics 流程
Sentieon | DNAscope LongRead PacBio 流程
Sentieon | DNAscope Ultima Genomics 流程
Sentieon | DNAscope Element Bio 流程
Sentieon | DNAscope LongRead Nanopore 流程
Sentieon混合分析流程 - DNAscope Hybrid
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(上)
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(下)
毅硕Sentieon | 泛基因组分析流程详解
Sentieon | 基于Illumina WGS数据的高精度、低成本的泛基因组分析方案
Sentieon | 基于Ultima WGS数据的高精度、低成本的泛基因组分析测评
Sentieon | 泛基因组分析流程详解—CHM13 (T2T) 更新版
Sentieon | DNAscope Pangenome:赋能人类高精度生殖筛查
Sentieon|植物泛基因组分析加速详解
毅硕Sentieon | RNA-seq 变异检测全流程详解
毅硕Sentieon | 物种全基因组(WGS)分析流程
毅硕Sentieon | 植物全基因组(WGS)分析流程
毅硕Sentieon | 小麦(Triticum aestivum)全基因组WGS分析流程
毅硕Sentieon | 水稻(Oryza sativa)全基因组WGS分析流程
毅硕Sentieon | 拟南芥(Arabidopsis thaliana)全基因组WGS分析流程
毅硕Sentieon | 马铃薯(Solanum tuberosum)全基因组WGS分析流程
毅硕Sentieon | 巨桉(Eucalyptus grandis)全基因组WGS分析流程
毅硕Sentieon | 向日葵(Helianthus annuus)全基因组WGS分析流程
毅硕Sentieon | 野草莓(Fragaria vesca)全基因组WGS分析流程
毅硕Sentieon | 银杏(Ginkgo biloba)全基因组WGS分析流程
毅硕Sentieon | 大豆(Glycine max)全基因组WGS分析流程
毅硕Sentieon | 陆地棉(Gossypium hirsutum)全基因组WGS分析流程
毅硕Sentieon | 胡桃(Juglans regia)全基因组WGS分析流程
毅硕Sentieon | 苹果(Malus domestica)全基因组WGS分析流程
毅硕Sentieon | 香蕉(musa acuminata)全基因组WGS分析流程
毅硕Sentieon | 罂粟(Papaver somniferum)全基因组WGS分析流程
毅硕Sentieon | 开心果(Pistacia vera)全基因组WGS分析流程
毅硕Sentieon | 毛果杨(Populus trichocarpa)全基因组WGS分析流程
毅硕Sentieon | 夏栎(Quercus robur)全基因组WGS分析流程
毅硕Sentieon | 蓖麻(Ricinus communis)全基因组WGS分析流程
毅硕Sentieon | 动物全基因组(WGS)分析流程
毅硕Sentieon | 猪(sus scrofa)全基因组WGS分析流程
毅硕Sentieon | 鸡(Gallus gallus)全基因组WGS分析流程
毅硕Sentieon | 家鼠(Mus musculus)全基因组WGS分析流程
毅硕Sentieon | 家犬(canis lupus familiaris)全基因组WGS分析流程
毅硕Sentieon | 东方蜜蜂(Apis cerana)全基因组WGS分析流程
毅硕Sentieon | 电鳗(Electrophorus electricus)全基因组WGS分析流程
毅硕Sentieon | 红隼(Falco tinnunculus)全基因组WGS分析流程
毅硕Sentieon | 家猫(Felis catus)全基因组WGS分析流程
毅硕Sentieon | 尼罗罗非鱼(Oreochromis niloticus)全基因组WGS分析流程
毅硕Sentieon | 狮子(Panthera leo)全基因组WGS分析流程
毅硕Sentieon | 东北虎(panthera tigris altaica)全基因组WGS分析流程
毅硕Sentieon | 黑猩猩(pan troglodytes)全基因组WGS分析流程
毅硕Sentieon | 中国鳖(pelodiscus sinensis)全基因组WGS分析流程
毅硕Sentieon | 褐家鼠(rattus norvegicus)全基因组WGS分析流程
毅硕Sentieon | 家牛(Bos taurus)全基因WGS分析流程
毅硕Sentieon | 虎河豚(takifugu rubripes)全基因WGS分析流程
毅硕Sentieon | 人类(Homo sapiens)全基因组WGS分析流程
毅硕Sentieon | 狮尾狒(theropithecus gelada)全基因组WGS分析流程
毅硕Sentieon | 草鱼(Ctenopharyngodon idella)全基因组WGS分析流程
毅硕Sentieon文献解读
Sentieon文献解读 | Population Sequencing
Sentieon文献解读 | Agrigenomics
Sentieon | Agrigenomics-泛基因组揭示小麦结构变异与栖息地及育种的关联
Sentieon文献解读 | Genetic Disease
Sentieon文献解读 | Tumor Sequencing
Sentieon文献解读 | Benchmark and Method Study
Sentieon文献解读 | Long Read Sequencing
Sentieon文献解读 | Clinical Trial
Sentieon文献解读 | Epidemiology
Sentieon文献解读 | Gene Editing
Sentieon文献解读 | Liquid Biopsy
Sentieon | TNscope 分析流程详解
Sentieon | TNscope WES Panel 分析流程详解
-
+
home
毅硕Sentieon | RNA-seq 变异检测全流程详解
# 一、前言 在转录组学研究中,RNA-seq技术已成为解码基因表达的核心工具,能够全面捕捉细胞中包括mRNA与非编码RNA在内的所有转录本信息,从而在单核苷酸水平揭示任意物种的转录活动全景,提供比传统微阵列技术更全面、更灵活的转录组分析手段,无需预先设计探针即可发现未知与稀有转录本,尤其在遗传疾病研究中展现出重要价值——例如其对肌肉疾病的诊断率可高达35%,显著超过全外显子组与全基因组测序。 然而,随着测序数据量的爆发式增长,基于传统GATK的流程在处理大规模数据集时日益暴露出耗时漫长、资源消耗巨大的瓶颈,许多研究团队不得不面对长达数天甚至数周的分析等待,严重制约了科研效率与临床转化。 为应对这一挑战,Sentieon开发了涵盖比对、去重、RNA连接点处理及变异检测的一体化加速模块,通过高度优化的算法与工程实现,大幅缩短全流程分析时间,为高通量RNA-seq数据分析提供了高效、可靠的解决方案。 * * * # 二、Sentieon RNA-seq 流程总览 Sentieon RNA-seq 流程严格遵循 Broad Institute 的 RNA分析流程的最佳实践金标准,包括了STAR比对,去重,RNA split的处理,Indel重比对(可选),BQSR,以及最终的变异检测等多个步骤。在本次的流程搭建中,我们利用Sentieon最新开发的STAR加速模块,与其他可用加速模块一起,完成了全流程的RNA变异检测流程的搭建工作。 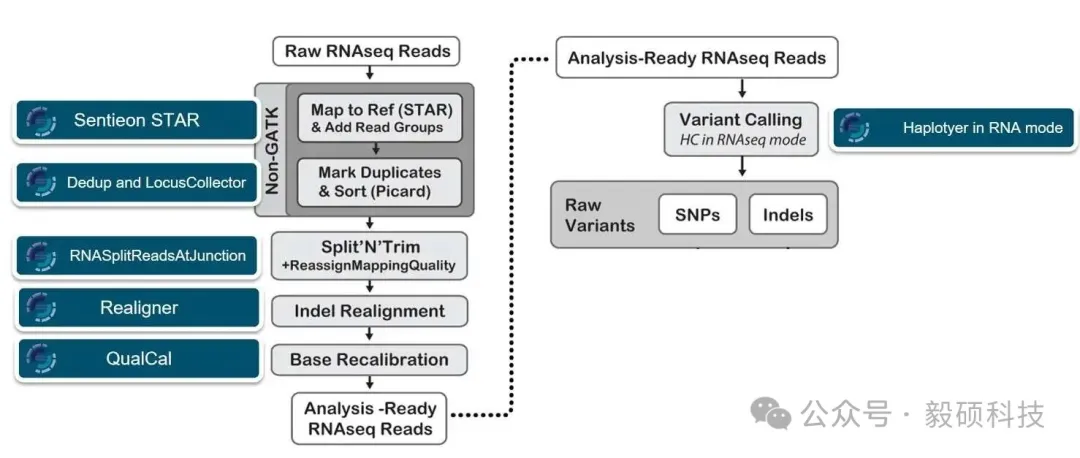 在这个生物信息学流程中,您需要以下输入: * 包含与您要分析的样本对应的参考基因组核苷酸序列的 FASTA 文件。 * 一个或多个包含待分析样本核苷酸序列的 FASTQ 文件。这些文件包含 DNA 测序的原始读段。软件支持输入使用 GZIP 压缩的 FASTQ 文件。软件仅支持包含 Sanger 格式(Phred+33)质量评分的文件。 * (可选)您希望包含在流程中的单核苷酸多态性数据库 (dbSNP) 数据,数据以 VCF 文件格式使用;您可以使用经 bgzip 压缩并已建立索引的 VCF 文件。 * (可选)您希望包含在流程中的多个已知站点集合,数据以 VCF 文件格式使用;您可以使用经 bgzip 压缩并已建立索引的 VCF 文件。 * * * # 三、分步详解 ## 1. 将读取序列比对到参考基因组 此步骤将 FASTQ 文件中的读取序列比对到 FASTA 文件中的参考基因组。 使用 STAR 运行单条命令即可高效地执行对齐,并使用 Sentieon® 软件创建 BAM 文件和排序: ``` sentieon STAR --runThreadN NUMBER_THREADS --genomeDir STAR_REFERENCE \ --readFilesIn SAMPLE SAMPLE2 --readFilesCommand "zcat" \ --outStd BAM_Unsorted --outSAMtype BAM Unsorted --outBAMcompression 0 \ --outSAMattrRGline ID:GROUP_NAME SM:SAMPLE_NAME PL:PLATFORM \ --twopassMode Basic --twopass1readsN -1 --sjdbOverhang READ_LENGTH_MINUS_1 \| sentieon util sort -r REFERENCE -o SORTED_BAM -t NUMBER_THREADS -i - ``` 该命令需要以下输入: * `NUMBER_THREADS`:计算过程中使用的计算机线程数。建议该数值不要超过系统可用计算核心数。建议STAR和util二进制文件使用相同数量的线程。 * `STAR_REFERENCE`:STAR基因组目录中FASTA参考文件的位置。您应确保STAR所需的所有参考数据都位于同一位置,且命名一致。 * `REFERENCE`:参考FASTA文件的位置。您应确保FASTA文件和相应的FAI索引文件与`STAR_REFERENCE genomeDir` 中的文件在构建和命名规则上保持一致。 * `SAMPLE`:样本FASTQ文件的位置。如果数据来自双端测序技术,您还需要输入SAMPLE2作为相应的配对样本FASTQ文件。您需要确保`--readFilesCommand`选项中使用的程序与输入FASTQ文件的压缩状态相匹配,例如:如果FASTQ文件已压缩,则应使用zcat;如果FASTQ文件未压缩,则应使用cat。 * `GROUP_NAME`:将添加到读取组标题行的读取组标识符。该标识符RG:ID在您计划使用的所有数据集中必须是唯一的。 * `SAMPLE_NAME`:要添加到读取组标题行的样本名称。 * `ILLUMINA`:用于对DNA进行测序的测序平台名称。可选选项包括:ILLUMINA(当fastq文件由Illumina™测序仪生成时);IONTORRENT(当fastq文件由Life Technologies™Ion-Torrent™测序仪生成时);ELEMENT(当fastq文件由Element Biosciences™测序仪生成时);DNBSEQ(当fastq文件由MGI™测序仪生成时);ULTIMA(当fastq文件由Ultima Genomics™测序仪生成时)。 * `READ_LENGTH_MINUS_1`:输入数据的读取长度减 1。 * `SORTED_BAM`:已排序映射的BAM输出文件的位置和文件名。将创建一个相应的索引文件(.bai)。 ## 2. 标记或去除重复序列 此步骤检测表明同一 RNA 分子被多次测序的读段。这些重复序列没有信息价值,不应作为额外证据。 在比对和排序之后,需要运行两条独立的命令来移除或标记 BAM 文件中的重复序列。第一条命令收集读取信息,第二条命令执行去重操作;该选项 `--rmdup`控制是否移除重复的读取序列(如果存在),或者仅将其标记为重复。 ``` sentieon driver -t NUMBER_THREADS -i SORTED_BAM \ --algo LocusCollector --rna [--consensus] [--umi_tag XR] --fun score_info SCORE.gz sentieon driver -t NUMBER_THREADS -i SORTED_BAM \ --algo Dedup [--rmdup] --score_info SCORE.gz DEDUPED_BAM ``` 以下输入是执行这些命令所必需的: * `NUMBER_THREADS`:计算过程中使用的计算机线程数。建议该数值不要超过系统可用计算核心数。 * `SORTED_BAM`:上一映射阶段存储结果的位置。 * `SCORE.gz`:临时分数输出文件的位置和文件名。请确保两个命令使用同一个文件。 * `DEDUPED_BAM`: 去重后的 BAM 输出文件的路径和文件名。系统将创建一个对应的索引文件(.bai)。 ## 3. 在连接点处分割读取序列 此步骤通过去除N碱基,同时保留分组信息,将RNA读取序列分割成外显子片段,并硬剪切掉任何超出内含子区域的序列。此外,此步骤还会将STAR的比对质量值从255转换为60,以使其与后续步骤的预期保持一致。 运行一条命令即可将读取数据拆分为外显子片段,并从 STAR 重新分配映射质量。 ``` sentieon driver -t NUMBER_THREADS -r REFERENCE -i DEDUPED_BAM \ --algo RNASplitReadsAtJunction --reassign_mapq 255:60 SPLIT_BAM ``` 该命令需要以下输入: * `NUMBER_THREADS`:计算过程中使用的计算机线程数。建议该数值不要超过系统可用计算核心数。 * `REFERENCE`:参考 REFERENCE 文件的位置。请确保此参考文件与映射阶段使用的文件相同。 * `DERUPED_BAM`:上一个去重阶段存储结果的位置。 * `SPLIT_BAM`:包含分割后序列的 BAM 输出文件的位置和文件名。系统将创建一个相应的索引文件(.bai)。 ## 4. 基础质量评分重新校准(BQSR;可选) 步骤修改序列读取数据中各个读取碱基的质量分数。此操作可消除测序方法造成的实验偏差。 只需执行一条命令,计算序列读取数据中单个读取基底所需的质量分数修改;实际的重新校准是在变体calling阶段进行的。 ``` sentieon driver -t NUMBER_THREADS -r REFERENCE \ -i DEDUPED_BAM --algo QualCal [-k KNOWN_SITES] RECAL_DATA.TABLE ``` 执行三条命令来应用重新校准并创建关于基础质量的复校准报告。第一条命令应用重新校准计算校准后数据表,并对 BAM 文件进行重新校准;第二条命令创建用于绘图的数据;第三条命令将校准数据表(前后)绘制成 PDF 中的图表。 ``` sentieon driver -t NUMBER_THREADS -r REFERENCE -i DEDUPED_BAM \ -q RECAL_DATA.TABLE --algo QualCal [-k KNOWN_SITES] \ RECAL_DATA.TABLE.POST [--algo ReadWriter RECALIBRATED_BAM] sentieon driver -t NUMBER_THREADS --algo QualCal --plot \ --before RECAL_DATA.TABLE --after RECAL_DATA.TABLE.POST RECAL_RESULT.CSV sentieon plot QualCal -o BQSR_PDF RECAL_RESULT.CSV ``` 该命令需要以下输入: * `NUMBER_THREADS`:计算过程中使用的计算机线程数。建议该数值不要超过系统可用的计算核心数。 * `REFERENCE`: 参考 FASTA 文件的位置。应该确保参考和映射阶段使用的是相同的。 * `DEDUPED_BAM`:上一个去重叠阶段存储结果的位置。 * `RECAL_DATA.TABLE`: 重新校准表的位置和文件名。 * `RECAL_DATA.TABLE.POST`:临时后期重新校准表的位置和文件名。 * `RECAL_RESULT.CSV`:用于绘图的临时重新校准结果输出文件的位置和文件名。 * `BQSR_PDF`:BSQR 结果输出文件的位置和文件名。 该命令可选以下输入: * `KNOWN_SITES`:VCF 文件作为已知站点集合的位置。你可以通过重复 -k KNOWN\_SITES 选项来包含多个已知站点集合。 * `RECALIBRATED_BAM`:重新校准后的 BAM 输出文件的位置和文件名。将创建一个对应的索引文件(.bai)。该输出为可选,因为Sentieon®变体呼叫器可使用校准前的BAM和重新校准表实时进行重新校准。 ## 5. RNA变异检测 此步骤识别您的数据相对于参考基因组显示变异的位点,并计算该位点上每个样本的基因型。 只需运行一条命令即可进行变异检测,并应用之前计算的 BQSR。RNA 变异检测可以使用 Haplotyper 算法或 DNAscope 算法。对于该命令,您应该使用相应的选项`--trim_soft_clip`,并设置比 DNAseq® 变异检测更低的最小 Phred 标度置信度阈值,这意味着您应该将`call_conf`和 都设置为 20,`emit_conf`而不是默认值 30。 ``` sentieon driver -t NUMBER_THREADS -r REFERENCE -i SPLIT_BAM \ [-q RECAL_DATA.TABLE] --algo Haplotyper --trim_soft_clip \ --call_conf 20 --emit_conf 20 [-d dbSNP] VARIANT_VCF ``` 如果要使用 DNAscope 进行基因分型,命令如下: ``` sentieon driver -t NUMBER_THREADS -r REFERENCE -i SPLIT_BAM \ [-q RECAL_DATA.TABLE] --algo DNAscope --trim_soft_clip \ --call_conf 20 --emit_conf 20 [-d dbSNP] VARIANT_VCF ``` 该命令需要以下输入: * `NUMBER_THREADS`:计算中过程使用的计算机线程数。建议该数值不要超过系统可用计算核心数。 * `REFERENCE`:参考 FASTA 文件的位置。请确保此参考文件与映射阶段使用的文件相同。 * `SPLIT_BAM`:前一个 RNASplitReadsAtJunction 阶段存储结果的位置。 * `VARIANT_VCF`:变异检测输出文件的位置和文件名。系统将创建一个相应的索引文件。该工具将输出一个扩展名为 .gz 的压缩文件。 该命令可选以下输入: * `RECAL_DATA.TABLE`:前一个 BQSR 阶段存储结果的位置。 * `dbSNP`:单核苷酸多态性数据库 (dbSNP) 的位置,该数据库将用于标记已知变异。您只能使用一个 dbSNP 文件。 ## 6. 质控 ``` $SENTIEON_EXEC driver -t $NT -r $REF_FASTA -i ${SAMPLE_NAME}.sorted.bam \ --algo MeanQualityByCycle $SAMPLEID.mq_metrics.txt \ --algo QualDistribution $SAMPLEID.qd_metrics.txt \ --algo GCBias --summary $SAMPLEID.gc_summary.txt $SAMPLEID.gc_metrics.txt \ --algo AlignmentStat --adapter_seq '' $SAMPLEID.aln_metrics.txt \ --algo InsertSizeMetricAlgo $SAMPLEID.is_metrics.txt ``` 使用sentieon driver计算多种测序质量指标,包括: * 全基因组测序指标(WgsMetricsAlgo)。 * 碱基质量分布、GC 偏差、插入片段长度等。 结果输出到多个质量指标的.txt文件,成功后创建metrics.ok。 **Sentieon RNAseq.pipe.sh 流程github地址:** https://github.com/Insvast/bioinformatics/blob/main/RNAseq.pipe.sh * * * # 四、实际运行测试 本次测试以大豆(Glycine max)为例,通过下载 SRP329754 项目数据并运行 Sentieon RNA-seq 分析流程,评估其在实际生产中的性能表现。 ## 1. 软件下载安装 * https://ftp.insvast.com/user/Sentieon/release/sentieon-genomics-202503.02.tar.gz * 软件下载链接用户名:insvast;密码:Ins@1234; ## 2. 服务器配置 * CPU为单颗Intel(R) Xeon(R) CPU E5-2680 v4 @ 2.40GHz 28线程 * 内存为64GB DDR4 * 系统为 Ubuntu 22.04.4 LTS ## 3. 参考基因组下载 **方法一:** ``` wget -c https://ftp.ncbi.nlm.nih.gov/genomes/all/GCF/000/004/515/GCF_000004515.6_Glycine_max_v4.0/GCF_000004515.6_Glycine_max_v4.0_genomic.fna.gz ``` **方法二:** ``` curl -C - -0 --progress-bar https://ftp.ncbi.nlm.nih.gov/genomes/all/GCF/000/004/515/GCF_000004515.6_Glycine_max_v4.0/GCF_000004515.6_Glycine_max_v4.0_genomic.fna.gz ``` **解压:** ``` gunzip GCF_000004515.6_Glycine_max_v4.0_genomic.fna.gz ``` ## 4. gtf 文件下载 ``` wget -c https://ftp.ncbi.nlm.nih.gov/genomes/all/GCF/000/004/515/GCF_000004515.6_Glycine_max_v4.0/GCF_000004515.6_Glycine_max_v4.0_genomic.gtf.gz gunzip GCF_000004515.6_Glycine_max_v4.0_genomic.gtf.gz ``` ## 5. SRP329754 fq数据下载 **数据下载路径:** ``` run_accession fastq_ftp fastq_md5 fastq_bytes fastq_aspera SRR15239595 ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_1.fastq.gz;ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_2.fastq.gz 5db4816bdf4ec4a410bd472379a686b7;249a52e7d6a6c9f7de209e9f7edb0184 1712409323;1733057413 fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_1.fastq.gz;fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_2.fastq.gz SRR15239596 ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/096/SRR15239596/SRR15239596_1.fastq.gz;ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/096/SRR15239596/SRR15239596_2.fastq.gz 0adb6f3cdbbfe2e676e550db0931cfe1;4fb147c397c9cb8d785498544b2fb55e 1741586497;1784157411 fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/096/SRR15239596/SRR15239596_1.fastq.gz;fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/096/SRR15239596/SRR15239596_2.fastq.gz SRR15239597 ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/097/SRR15239597/SRR15239597_1.fastq.gz;ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/097/SRR15239597/SRR15239597_2.fastq.gz 997ad2ae013712002621a3bd064c5f63;89ceadd0c288a9136f80e11365c58ae1 1715292563;1753639256 fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/097/SRR15239597/SRR15239597_1.fastq.gz;fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/097/SRR15239597/SRR15239597_2.fastq.gz SRR15239594 ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/094/SRR15239594/SRR15239594_1.fastq.gz;ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/094/SRR15239594/SRR15239594_2.fastq.gz ca56b89fb75045bec8f3cdf48b0ada45;e547c24226677620367fab07572743f1 1855453230;1883755185 fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/094/SRR15239594/SRR15239594_1.fastq.gz;fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/094/SRR15239594/SRR15239594_2.fastq.gz ``` **方法一:** ``` ascp -QT -l 300m -P33001 -i /home/snpbio/.aspera/connect/etc/asperaweb_id_dsa.openssh era-fasp@fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_1.fastq.gz ascp -QT -l 300m -P33001 -i /home/snpbio/.aspera/connect/etc/asperaweb_id_dsa.openssh era-fasp@fasp.sra.ebi.ac.uk:/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_2.fastq.gz ``` **方法二:** ``` wget -c ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_1.fastq.gz wget -c ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_2.fastq.gz ``` **方法三:** ``` curl -C - -0 --progress-bar ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_1.fastq.gz curl -C - -0 --progress-bar ftp.sra.ebi.ac.uk/vol1/fastq/SRR152/095/SRR15239595/SRR15239595_2.fastq.gz ``` 如果未配置ascp可以直接 wget或curl下载。 ## 6. 创建 index ``` # 配置 sentieon 后 sentieon STAR --runMode genomeGenerate --runThreadN 64 --genomeDir star_index --genomeFastaFiles rename.fa --sjdbGTFfile rename.gtf --sjdbOverhang 149 ``` ## 7. 分析运行 ``` bash /home/snpbio/test_rna_pipe/RNAseq.pipe.sh \ SRR15239594 /home/snpbio/test_rna_pipe/out \ /home/snpbio/test_rna_pipe/data/SRR15239594_1.fastq.gz \ /home/snpbio/test_rna_pipe/data/SRR15239594_2.fastq.gz \ /home/snpbio/data/ref/03_Glycine_max/rename.fa \ /home/snpbio/data/ref/03_Glycine_max/star_index bash /home/snpbio/test_rna_pipe/RNAseq.pipe.sh \ SRR15239595 /home/snpbio/test_rna_pipe/out \ /home/snpbio/test_rna_pipe/data/SRR15239595_1.fastq.gz \ /home/snpbio/test_rna_pipe/data/SRR15239595_2.fastq.gz \ /home/snpbio/data/ref/03_Glycine_max/rename.fa \ /home/snpbio/data/ref/03_Glycine_max/star_index bash /home/snpbio/test_rna_pipe/RNAseq.pipe.sh \ SRR15239596 /home/snpbio/test_rna_pipe/out \ /home/snpbio/test_rna_pipe/data/SRR15239596_1.fastq.gz \ /home/snpbio/test_rna_pipe/data/SRR15239596_2.fastq.gz \ /home/snpbio/data/ref/03_Glycine_max/rename.fa \ /home/snpbio/data/ref/03_Glycine_max/star_index bash /home/snpbio/test_rna_pipe/RNAseq.pipe.sh \ SRR15239597 /home/snpbio/test_rna_pipe/out \ /home/snpbio/test_rna_pipe/data/SRR15239597_1.fastq.gz \ /home/snpbio/test_rna_pipe/data/SRR15239597_2.fastq.gz \ /home/snpbio/data/ref/03_Glycine_max/rename.fa \ /home/snpbio/data/ref/03_Glycine_max/star_index ``` * * * # 五、分析结果展示 ## 1. 输出文件 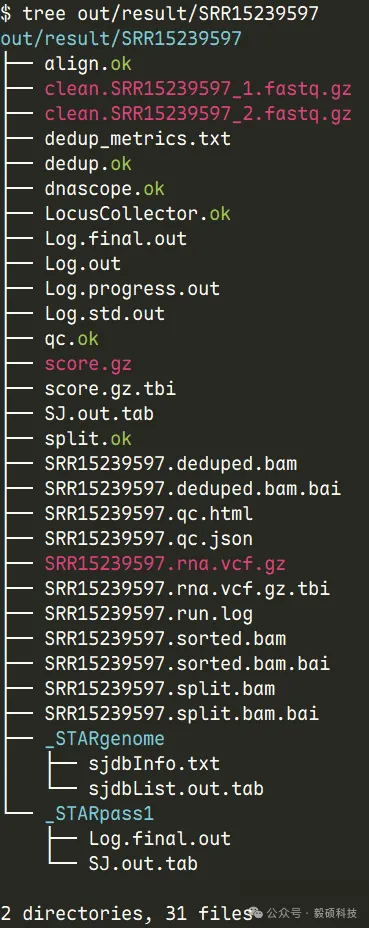 ## 2. qc结果展示 |SampleID|SRR15239594|SRR15239595|SRR15239596|SRR15239597| |--|--|--|--|--| |RawReads|57262380|52761114|53753400|52997050| |RawBases(GB)|8.567011212|7.89425484|8.036257266|7.928455372| |CleanReads|56680170|52212500|53190052|52515780| |CleanBases(GB)|8.455572338|7.78747427|7.92739016|7.835067136| |Effective(%)|98.6992|98.6474|98.6453|98.8221| |Error(%)|0.0246|0.0246|0.0248|0.0246| |GC(%)|46.7967|46.7395|46.6272|46.7532| |Q20(%)|98.4867|98.4861|98.395|98.4615| |Q30(%)|95.3402|95.3228|95.113|95.2679| |Duplicate(%)|38.2748|38.4417|37.0389|35.7556| |MedianInsertSize|406|417|400|371| |Number of input reads|28340085|26106250|26595026|26257890| |Uniquely mapped reads number|25827328|23713128|23632741|23537293| |Uniquely mapped reads %|91.13%|90.83%|88.86%|89.64%| 本次测试的4个SRR样本数据产出稳定(单样本~ 8GB),有效率>98.6%且Q30高达95.1%以上,测序质量与准确度极佳。GC含量(~46.7%)与插入片段分布表现出高度的样本间一致性,唯一比对率稳定在90%左右,证明文库质量优异,完全符合差异表达或变异检测等高标准下游分析要求。 ## 3. 用时统计 | |SRR15239594|SRR15239595|SRR15239596|SRR15239597| |--|--|--|--|--| |fastq文件质控时间(min)|2.7|2.76|2.73|2.91| |比对时间(min)|5.13|5.21|5.28|5.48| |去重时间(min)|0.8|0.816|0.83|0.88| |SplitNCigarReads时间(min)|1.21|2.3|2.43|1.95| |DNAscope变异检测时间(min)|1.16|1.3|1.21|1.36| |统计metrics质控信息时间(min)|0.72|0.88|0.9|0.87| |总时间|11.72|13.266|13.38|13.45| 在28核测试服务器上8G数据量的大豆RNAseq数据平均分析仅耗时13min,极大缩短了分析时间,加快科研成果转化。 Sentieon在不断的优化算法的运行效率,为科研工作者提供更快速、更经济的基因检测方案。若您刚好有需要检测的数据,不妨来申请试用Sentieon吧! **Sentieon RNA-seq官方文档:** https://support.sentieon.com/manual/RNA_call/rna/#
chsnp
March 5, 2026, 11:54 a.m.
Forward
Favorites
Last
Next
Scan the QR Code
Copy link
Scan the QR code to share.
Copy link
Markdown file
Word document
PDF document
PDF document (print)
share
link
type
password
Update password
Validity period