Sentieon
Sentieon 中文手册
Sentieon 中文手册(上册)
Sentieon 中文手册(下册)
Sentieon 软件应用教程
Sentieon | 联合Dell、AMD开发基因组大数据分析加速方案
Sentieon | 应用教程: 利用Sentieon Python API引擎为自研算法加速
Sentieon | 应用教程: 关于读段组的建议
Sentieon | 应用教程: 使用DNAscope对HiFi长读长数据进行胚系变异检测分析
Sentieon | 应用教程: TNscope® 使用机器学习模型进行有匹配正常样本的体细胞变异发现
Sentieon | 应用教程: CCDG使用Sentieon®的功能等效流程
Sentieon | 应用教程: 利用共识功能去除PCR重复
Sentieon | 应用教程: 适用于PacBio HiFi和Oxford Nanopore长读长测序数据的结构变异检测
Sentieon | 应用教程: 使用 Sentieon进行大型基因组重测序分析
Sentieon | 应用教程: 体细胞SNP/Indel变异检测
Sentieon | 应用教程: DNAscope使用机器学习模型进行胚系变异调用
Sentieon | 应用教程: 唯一分子标识符(UMI)
Sentieon | 应用教程: Sentieon分布模式
Sentieon | 应用教程:使用CNVscope进行CNV检测分析
Sentieon发布核心家系(trio)基因分析最佳实践方案
Sentieon推出Segdup-caller:针对片段重复区域的专用精准变异检测工具
Sentieon-cli | DNAscope WES 流程单条命令版本详解
Sentieon | DNAscope 核心家系(trio) WES 分析全流程详解
Sentieon | DNAscope Hybrid长短读长混合分析流程详解及评测
Sentieon | DNAscope LongRead:面向ONT WGS的快速、高精度、低成本变异检测流程
重磅发布|真迈生物联合Sentieon打造SURFSeq 5000 CMS + DNAscope工作流
Sentieon软件版本更新
Sentieon | 发布V202503.01版本
Sentieon | 发布V202503.02版本
Sentieon | 发布V202503.03版本
Sentieon | 发布V202503.04版本
Sentieon软件快速入门指南
Sentieon 软件模块总述
Sentieon 特色流程 - DNAscope
Sentieon | DNAscope Illumina 流程
sentieon | DNAscope Complete Genomics 流程
Sentieon | DNAscope LongRead PacBio 流程
Sentieon | DNAscope Ultima Genomics 流程
Sentieon | DNAscope Element Bio 流程
Sentieon | DNAscope LongRead Nanopore 流程
Sentieon混合分析流程 - DNAscope Hybrid
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(上)
Sentieon推出混合型短读长和长读长变异检测DNAscope Hybrid流程(下)
毅硕Sentieon | 泛基因组分析流程详解
Sentieon | 基于Illumina WGS数据的高精度、低成本的泛基因组分析方案
Sentieon | 基于Ultima WGS数据的高精度、低成本的泛基因组分析测评
Sentieon | 泛基因组分析流程详解—CHM13 (T2T) 更新版
Sentieon | DNAscope Pangenome:赋能人类高精度生殖筛查
Sentieon|植物泛基因组分析加速详解
毅硕Sentieon | RNA-seq 变异检测全流程详解
毅硕Sentieon | 物种全基因组(WGS)分析流程
毅硕Sentieon | 植物全基因组(WGS)分析流程
毅硕Sentieon | 小麦(Triticum aestivum)全基因组WGS分析流程
毅硕Sentieon | 水稻(Oryza sativa)全基因组WGS分析流程
毅硕Sentieon | 拟南芥(Arabidopsis thaliana)全基因组WGS分析流程
毅硕Sentieon | 马铃薯(Solanum tuberosum)全基因组WGS分析流程
毅硕Sentieon | 巨桉(Eucalyptus grandis)全基因组WGS分析流程
毅硕Sentieon | 向日葵(Helianthus annuus)全基因组WGS分析流程
毅硕Sentieon | 野草莓(Fragaria vesca)全基因组WGS分析流程
毅硕Sentieon | 银杏(Ginkgo biloba)全基因组WGS分析流程
毅硕Sentieon | 大豆(Glycine max)全基因组WGS分析流程
毅硕Sentieon | 陆地棉(Gossypium hirsutum)全基因组WGS分析流程
毅硕Sentieon | 胡桃(Juglans regia)全基因组WGS分析流程
毅硕Sentieon | 苹果(Malus domestica)全基因组WGS分析流程
毅硕Sentieon | 香蕉(musa acuminata)全基因组WGS分析流程
毅硕Sentieon | 罂粟(Papaver somniferum)全基因组WGS分析流程
毅硕Sentieon | 开心果(Pistacia vera)全基因组WGS分析流程
毅硕Sentieon | 毛果杨(Populus trichocarpa)全基因组WGS分析流程
毅硕Sentieon | 夏栎(Quercus robur)全基因组WGS分析流程
毅硕Sentieon | 油棕(Elaeis guineensis)全基因组WGS分析流程
毅硕Sentieon | 高粱(Sorghum bicolor)全基因组WGS分析流程
毅硕Sentieon | 玉米(Zea mays)全基因组WGS分析流程
毅硕Sentieon | 动物全基因组(WGS)分析流程
毅硕Sentieon | 猪(sus scrofa)全基因组WGS分析流程
毅硕Sentieon | 鸡(Gallus gallus)全基因组WGS分析流程
毅硕Sentieon | 家鼠(Mus musculus)全基因组WGS分析流程
毅硕Sentieon | 家犬(canis lupus familiaris)全基因组WGS分析流程
毅硕Sentieon | 东方蜜蜂(Apis cerana)全基因组WGS分析流程
毅硕Sentieon | 电鳗(Electrophorus electricus)全基因组WGS分析流程
毅硕Sentieon | 红隼(Falco tinnunculus)全基因组WGS分析流程
毅硕Sentieon | 家猫(Felis catus)全基因组WGS分析流程
毅硕Sentieon | 尼罗罗非鱼(Oreochromis niloticus)全基因组WGS分析流程
毅硕Sentieon | 狮子(Panthera leo)全基因组WGS分析流程
毅硕Sentieon | 东北虎(panthera tigris altaica)全基因组WGS分析流程
毅硕Sentieon | 黑猩猩(pan troglodytes)全基因组WGS分析流程
毅硕Sentieon | 中国鳖(pelodiscus sinensis)全基因组WGS分析流程
毅硕Sentieon | 褐家鼠(rattus norvegicus)全基因组WGS分析流程
毅硕Sentieon | 家牛(Bos taurus)全基因WGS分析流程
毅硕Sentieon | 虎河豚(takifugu rubripes)全基因WGS分析流程
毅硕Sentieon | 人类(Homo sapiens)全基因组WGS分析流程
毅硕Sentieon | 狮尾狒(theropithecus gelada)全基因组WGS分析流程
毅硕Sentieon | 草鱼(Ctenopharyngodon idella)全基因组WGS分析流程
毅硕Sentieon | 绵羊(Ovis aries)全基因组WGS分析流程
毅硕Sentieon | 北极熊(ursus maritimus)全基因组WGS分析流程
毅硕Sentieon文献解读
Sentieon文献解读 | Population Sequencing
Sentieon文献解读 | Agrigenomics
Sentieon | Agrigenomics-泛基因组揭示小麦结构变异与栖息地及育种的关联
Sentieon文献解读 | Genetic Disease
Sentieon文献解读 | Tumor Sequencing
Sentieon文献解读 | Benchmark and Method Study
Sentieon文献解读 | Long Read Sequencing
Sentieon文献解读 | Clinical Trial
Sentieon文献解读 | Epidemiology
Sentieon文献解读 | Gene Editing
Sentieon文献解读 | Liquid Biopsy
Sentieon | TNscope 分析流程详解
Sentieon | TNscope WES Panel 分析流程详解
-
+
home
Sentieon | 泛基因组分析流程详解—CHM13 (T2T) 更新版
# 泛基因组基本信息 在传统基因组学分析中,研究人员通常把一个“参考基因组”作为坐标基础,用于 reads 比对、变异检测和下游注释。这种模式成熟、稳定,但单一线性参考无法完整代表物种内不同个体的遗传多样性。对于结构复杂、高度多态或存在大片段插入缺失的区域,单一参考可能带来参考偏倚,影响 reads 比对和变异识别。 泛基因组(pan-genome)通过整合多个个体或多个单倍型的序列信息,提供比单一参考更丰富的遗传表示。它不再把一个个体的基因组视作“标准答案”,而是把物种内共享和特异的序列变异统一纳入分析框架。 泛基因组:指的是一个物种所有个体中全部基因的集合。它不再依赖于单个参考基因组,而是承认没有任何一个个体能够拥有其物种的全部基因。 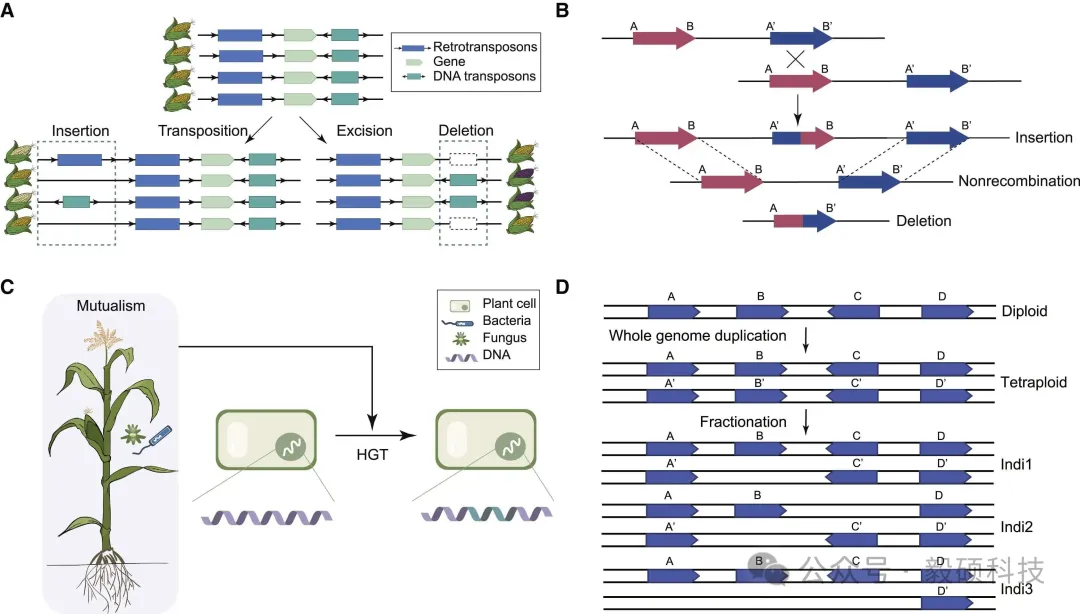 *图1 植物泛基因组中与可变DNA序列相关的结构变异(SVs)的主要驱动力概述* 为更好地理解泛基因组,科学家将其划分为三个部分: ## 1. 核心基因组(Core Genome) 定义:在所有或绝大多数(通常>95%)个体中都存在的基因集合。 角色:它们是物种的“生存必需品”,编码维持基本生命活动所必需的蛋白质,如基础代谢、DNA复制、核糖体组装等。这是物种稳定的遗传基础。 ## 2. 可变基因组(Dispensable / Variable / Accessory Genome) 定义:只存在于部分个体中。 角色:它们是物种的“自适应工具包”,通常与环境适应性和功能多样性密切相关。例如: * 抗生素耐药性基因 * 致病因子(毒力基因) * 特殊代谢途径(如降解某种污染物的能力) ## 3. 独特基因组(Unique/Strain-Specific Genes) 定义:仅存在于某一个特定个体中的基因。 角色:通常是最近通过水平基因转移(HGT) 或快速进化产生的新基因,赋予了该个体极其独特的性状。 **一个生动的比喻:乐高模型** 单一参考基因组:就像是一辆标准版乐高跑车的说明书。 泛基因组:则是整个乐高汽车系列所有型号(跑车、卡车、消防车、警车)的全部零件库。 * 核心基因组:是所有型号都必需的通用零件(车轮、车窗)。 * 可变基因组:是某些型号特有的功能零件(消防车的云梯、警车的警灯)。 * 独特基因组:可能是某款限量版独有的特殊装饰零件。 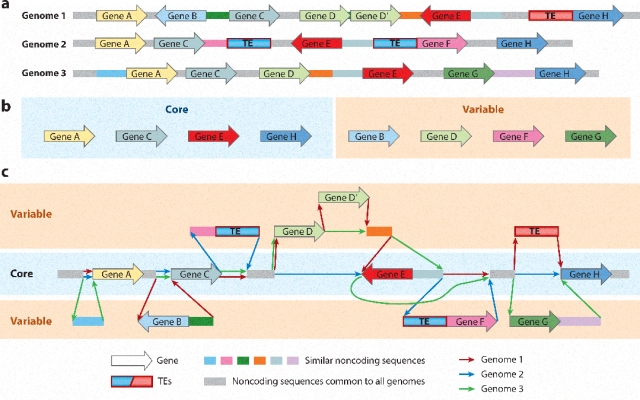 *图2 核心基因与非核心基因示意图* ## 一、泛基因组研究的重要性 ### 1. 弥补参考基因组的缺陷 微生物或高等动植物个体间的基因内容差异巨大。研究表明,在某些细菌物种中,高达30%-40%的基因不存在于参考基因组中。而泛基因组分析能全面回收这些“缺失的遗传力”。 ### 2. 精准追踪病原体与抗生素耐药性 许多毒力因子和耐药基因都位于可变基因组中。通过构建病原菌(如肺炎链球菌、大肠杆菌)的泛基因组,可以精准追踪这些危险基因的传播轨迹和组合方式,为流行病学调查和公共卫生干预提供关键线索。 ### 3. 驱动下一代动植物育种革命 这是泛基因组在农业中最激动人心的应用。作物的泛基因组(如水稻、番茄、玉米)揭示了现代高产栽培品种在驯化过程中丢失的大量优异基因(如抗病、抗逆、风味物质合成基因)。育种家可以将这些“丢失的宝藏”重新引入品种,培育出更强壮、更美味、更环境友好的新品种。 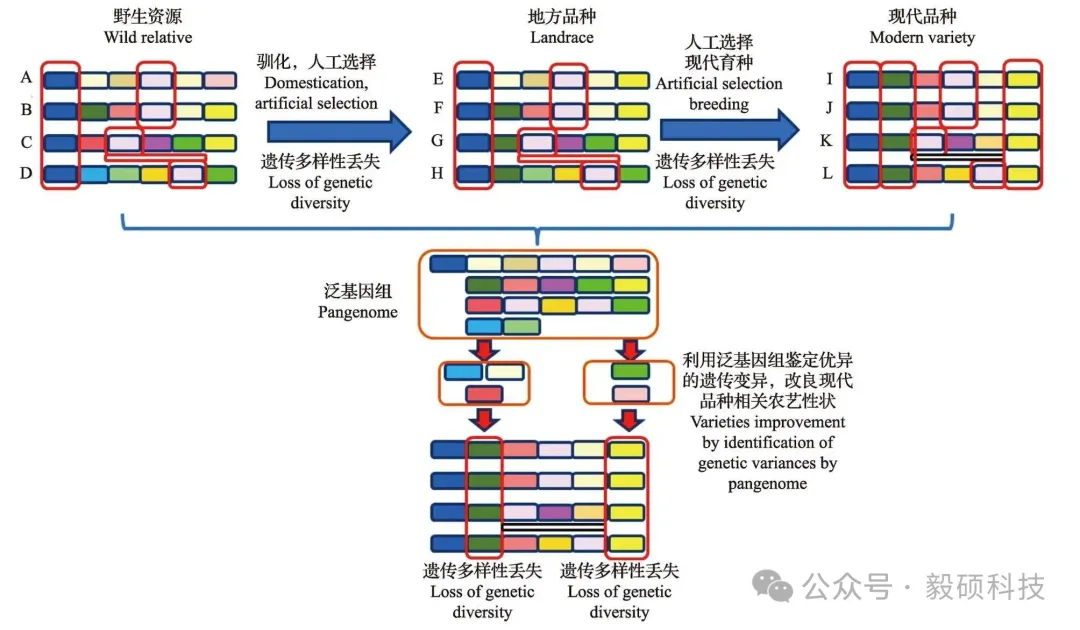 *图3 泛基因组在遗传变异发掘和植物分子育种中应用* 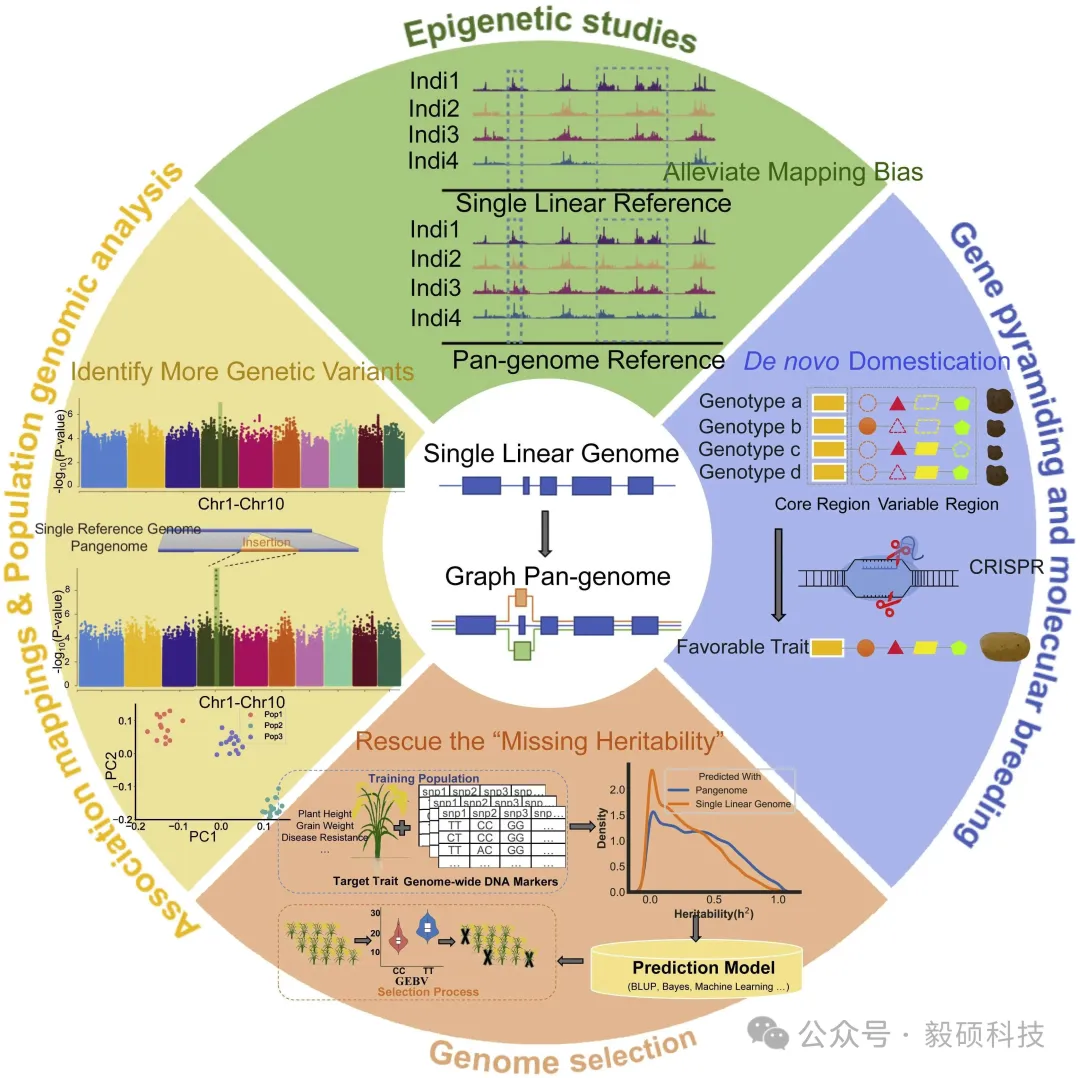 *图4 泛基因组在遗传研究和育种实践中的应用* ### 4. 助力人类精准医学 人类泛基因组参考联盟(HPRC) 正致力于构建代表全球人群多样性的泛基因组参考。这将极大地改善基于欧洲人群单一参考基因组的偏差,让遗传病诊断、药物基因组学研究等更精准地服务于全人类。 ## 二、植物泛基因组的主要研究进展及应用 目前,研究人员已在水稻、玉米、小麦、大豆、棉花、高粱、番茄等十余种作物中,通过Map-to-pan策略、全基因组序列比对或图形基因组技术成功构建了泛基因组图谱。这些泛基因组所包含的序列集合大小可达到单一线性基因组的3倍以上,显著扩展了遗传变异的覆盖范围。借助泛基因组图谱,全基因组关联分析(GWAS)能够检测到以往基于单个基因组无法识别的基因位点,进一步凸显了泛基因组在结构完整性和变异检测准确性方面的优势。 此外,相关研究还系统总结了泛基因组中非编码区域的多态性特征,以及整合多个物种形成的“超级泛基因组”资源,强调了挖掘非编码区功能变异及利用野生种基因资源在作物改良中的重要作用。 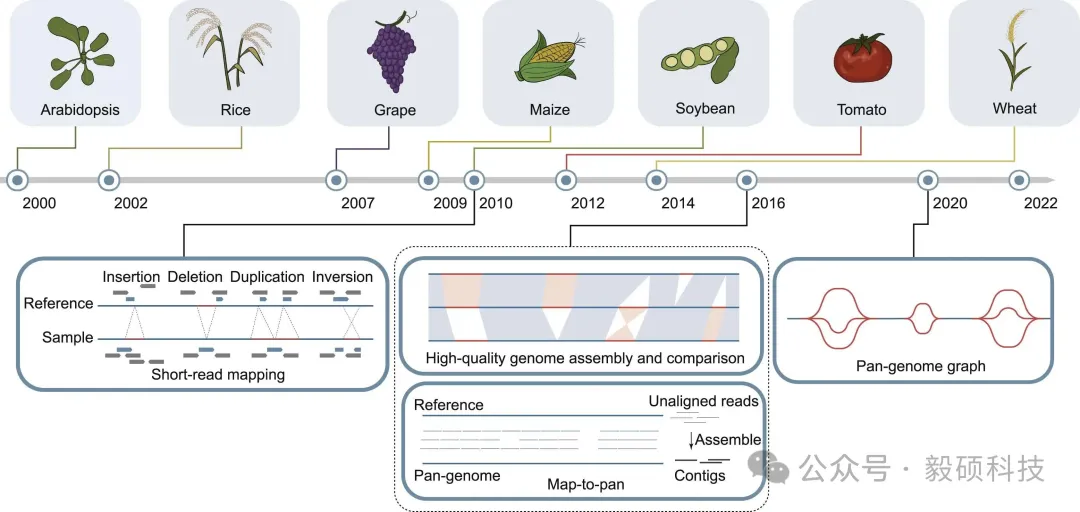 *图5 植物参考基因组构建(上)和植物泛基因组表征方法(下)的主要事件时间线* **泛基因组研究流程:** 构建全景(特征分析)→ 深度挖掘(变异分析/新基因鉴定)→ 历史解读(系统进化)→ 实践应用(群体变异与育种)。 * * * # Sentieon 泛基因组分析流程 Sentieon DNAscope Pangenome 是面向短读长 DNA 测序数据的泛基因组分析流程。该流程利用 pangenome graph 进行 reads 比对和变异检测,尤其适用于高多样性、结构复杂或传统线性参考难以准确表示的区域。 新版本命令为: ``` sentieon-cli dnascope-pangenome ``` 相较旧版使用的 sentieon-cli pangenome 写法,新版对参数进行了整理:核心输入包括参考 FASTA、GBZ 图文件、HAPL 单倍型文件、population VCF 和模型包;CHM13 (T2T) 与非 GRCh38 支持也通过新增参数明确下来。 ## 一、系统环境 ### 1. Sentieon 软件版本 DNAscope Pangenome 需要 Sentieon 软件包版本 202503.02 或更高版本。如果使用新版 CHM13 (T2T) 或非 GRCh38 参数,建议同步更新 `sentieon-cli` (当前最新版本为1.6.3)与 Sentieon 主程序,避免 CLI 参数不匹配。 ### 2. 配套工具 |软件|用途|版本要求| |--|--|--| |`samtools`|FASTA/BAM/CRAM 相关操作|1.16 或更高版本| |`vg`|pangenome 创建和图操作|1.68 版本| |`KMC`|k-mer 计数|3 或更高版本| |`bcftools`|VCF 操作|1.22 或更高版本| |`MultiQC`|汇总 QC 报告|1.18 或更高版本| |`segdup-caller`|片段重复区域变异检测,可选|0.5.1 或更高版本| |`ExpansionHunter`|短串联重复扩增检测,可选|按工具要求配置| |`T1K`|HLA/KIR 分型,可选|需 `run-t1k` 可执行文件| 这些可执行文件需要位于用户的 `PATH` 环境变量中。 推荐安装命令: ``` conda create -n sentieon_cli_env python=3.11 conda install -c bioconda samtools=1.23.1 bcftools=1.23.1 bedtools mosdepth multiqc fastp vcftools kmc hificnv -y conda install -c conda-forge python-levenshtein pip install sentieon_cli # run-t1k 需要 手动编译安装,并链接到PATH环境变量,mamba install t1k 会附带更新samtools到0.1.19版本 git clone https://github.com/mourisl/T1K.git cd T1k make # 检查 which samtools bcftools bedtools mosdepth multiqc fastp vcftools kmc run-t1k vg sentieon-cli /apps/miniforge3/envs/sentieon_cli_env/bin/samtools /apps/miniforge3/envs/sentieon_cli_env/bin/bcftools /apps/miniforge3/envs/sentieon_cli_env/bin/bedtools /apps/miniforge3/envs/sentieon_cli_env/bin/mosdepth /apps/miniforge3/envs/sentieon_cli_env/bin/multiqc /apps/miniforge3/envs/sentieon_cli_env/bin/fastp /apps/miniforge3/envs/sentieon_cli_env/bin/vcftools /apps/miniforge3/envs/sentieon_cli_env/bin/kmc /miniconda3/envs/sentieon_cli_env/bin/run-t1k /apps/miniforge3/envs/sentieon_cli_env/bin/vg /apps/miniforge3/envs/sentieon_cli_env/bin/sentieon-cli ``` ## 二、输入数据要求 ### 1. 参考基因组 流程会相对于高质量参考基因组识别变异。除参考 FASTA 外,还需要提供 `.fai` 索引文件;如果从 FASTQ 开始进行 BWA 线性比对,还需要 BWA index。 * 对于 GRCh38,建议使用不含 ALT contigs 的参考版本,并保持 contig 命名与 pangenome、BED、VCF 文件一致。 * 对于 CHM13 (T2T),必须确保参考 FASTA、GBZ、HAPL、population VCF、BED 以及已有 BAM/CRAM 都在同一坐标体系下,不能混用 GRCh38 和 CHM13 文件。 下载 T2T参考基因组: * https://42basepairs.com/browse/s3/human-pangenomics/submissions/89DF6EFF-E289-49A2-B2B4-ABF13E43731B--PanGenie?file=chm13v2.0\_maskedY\_rCRS.fa&preview= ``` aws s3 cp s3://human-pangenomics/submissions/89DF6EFF-E289-49A2-B2B4-ABF13E43731B--PanGenie/chm13v2.0_maskedY_rCRS.fa . --no-sign-request aws s3 cp s3://human-pangenomics/submissions/89DF6EFF-E289-49A2-B2B4-ABF13E43731B--PanGenie/chm13v2.0_maskedY_rCRS.fa.fai . --no-sign-request ``` ### 2. 泛基因组文件 新版 DNAscope Pangenome 主要需要以下 pangenome 文件: |文件|常见格式|说明| |--|--|--| |图文件|`.gbz`|pangenome graph 文件,包含图结构和路径信息| |单倍型文件|`.hapl`|pangenome haplotype 信息| |参考 FASTA|`` .fa/.fasta ``|线性参考,用于坐标体系和变异定义| 旧版流程中常见的 `.snarls` 和 `.xg` 文件在原文示例中用于 `vg` 相关步骤;在当前 `sentieon-cli dnascope-pangenome` 文档命令中,用户侧核心输入已简化为 `--gbz` 和 `--hapl`。 下载链接: https://data.humanpangenome.org/alignments 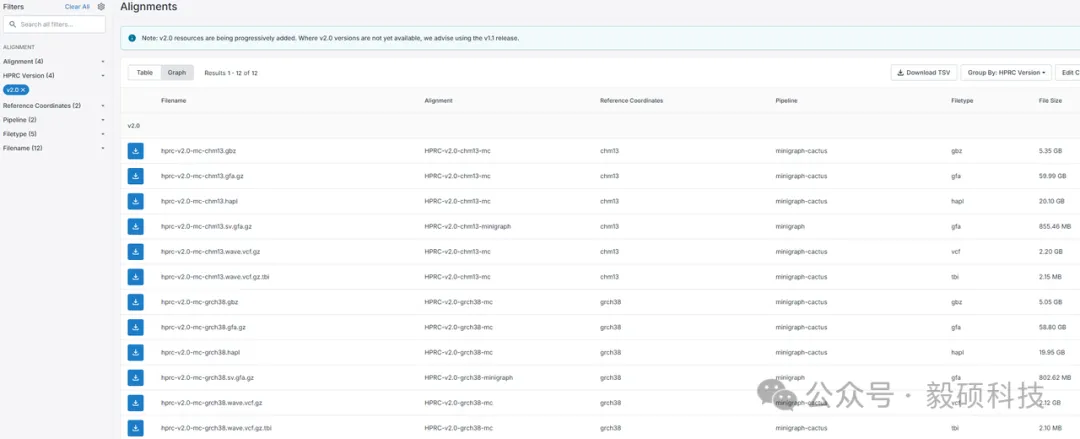 ### 3. 模型包(Model bundle) DNAscope Pangenome 需要 Sentieon model bundle。模型包需与测序平台、分析流程和 population VCF 匹配。Sentieon models 仓库中提供了 pangenome 相关模型入口,例如 Illumina whole genome pangenome 和 Ultima whole genome pangenome 模型。 * Sentieon models 仓库 https://github.com/Sentieon/sentieon-models ### 4. Population VCF 新版流程明确要求提供 population VCF: ``` --pop_vcf POP_VCF ``` population VCF 必须与 model bundle 匹配,并且坐标体系要与当前参考一致。使用 CHM13 时,不能直接沿用 GRCh38 的 population VCF。 下载路径: https://ftp.sentieon.com/public/CHM13/population/ ``` wget https://ftp.sentieon.com/public/CHM13/population/pop-v20_chm13-20260528.vcf.gz wget https://ftp.sentieon.com/public/CHM13/population/pop-v20_chm13-20260528.vcf.gz.tbi ``` 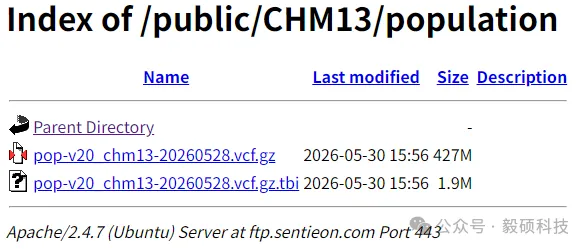 * * * # 使用方法 ## 一、从 FASTQ 进行泛基因组比对和变异识别 新版 FASTQ 输入命令结构如下: ``` sentieon-cli dnascope-pangenome \ -r REFERENCE \ --hapl HAPL \ --gbz GBZ \ --r1_fastq R1_FASTQ \ --r2_fastq R2_FASTQ \ --readgroup READGROUP \ --pop_vcf POP_VCF \ -m MODEL_BUNDLE \ [-b INTERVAL_FILE] \ [-d DBSNP] \ [-t NUMBER_THREADS] \ [--pcr_free] \ [-g] \ [--call_svs] \ [--expansion_catalog EXPANSION_CATALOG] \ [--segdup_caller [GENES]] \ [--t1k_hla_seq T1K_HLA_SEQ --t1k_hla_coord T1K_HLA_COORD] \ [--t1k_hla_locus T1K_HLA_LOCUS] \ [--t1k_kir_seq T1K_KIR_SEQ --t1k_kir_coord T1K_KIR_COORD] \ [--t1k_kir_locus T1K_KIR_LOCUS] \ [--skip_metrics] \ [--skip_multiqc] \ SAMPLE_VCF ``` 必需参数包括: * `-r REFERENCE`:参考基因组 FASTA。 * `--hapl HAPL`:pangenome haplotype 文件。 * `--gbz GBZ`:GBZ 格式 pangenome graph。 * `--r1_fastq` / `--r2_fastq`:双端 FASTQ 输入。 * `--readgroup READGROUP`:样本 read group 信息。 * `--pop_vcf POP_VCF`:population VCF。 * `-m MODEL_BUNDLE`:Sentieon model bundle。 * `SAMPLE_VCF`:主输出 VCF,需以 `.vcf.gz` 结尾。 ## 二、从已排序 BAM/CRAM 进行变异识别 如果已有排序后的 BAM 或 CRAM,可使用 `-i` 输入: ``` sentieon-cli dnascope-pangenome \ -r REFERENCE \ --hapl HAPL \ --gbz GBZ \ -i SAMPLE_INPUT \ --pop_vcf POP_VCF \ -m MODEL_BUNDLE \ [-b INTERVAL_FILE] \ [-d DBSNP] \ [-t NUMBER_THREADS] \ [--pcr_free] \ [-g] \ [--call_svs] \ SAMPLE_VCF ``` BAM/CRAM 的坐标体系必须与 `-r` 指定的参考一致。例如,GRCh38 坐标的 CRAM 不能直接放入 CHM13 流程中运行。 * * * # CHM13 (T2T)更新重点 新版 Sentieon CLI 明确表示:DNAscope Pangenome 目前完整支持 GRCh38 和 CHM13 (T2T) 参考基因组。默认情况下,流程仍假设 pangenome 中嵌入的参考路径是 GRCh38,并会按照 GRCh38 相关规则检查 contig 名称、长度和 pangenome 文件命名。 因此,当使用 CHM13 时,需要加入以下参数: ``` --pangenome_ref_name 'CHM13' \ --pangenome_contig_prefix 'CHM13#0#' \ --skip_contig_checks \ --skip_pangenome_name_checks ``` 参数解释:`--pangenome_ref_name`指定 pangenome graph 中的参考样本名。默认值是 `GRCh38`。使用 CHM13 时设置为: ``` --pangenome_ref_name CHM13 ``` 如果使用其他 Minigraph-Cactus pangenome,应设置为 graph 中实际嵌入的参考路径名。`--pangenome_contig_prefix`指定 pangenome contig 名称前缀。GRCh38 默认是: ``` GRCh38#0# ``` CHM13 示例为: ``` --pangenome_contig_prefix 'CHM13#0#' ``` 该前缀用于将 pangenome 比对结果 lift back 到线性参考坐标时识别路径名称,因此必须与 GBZ/HAPL 中的路径命名一致。 * `--skip_contig_checks` 跳过针对 GRCh38 canonical contigs 的名称和长度检查。使用 CHM13 或其他非 GRCh38 参考时需要添加。 * `--skip_pangenome_name_checks` 跳过 HPRC GRCh38 pangenome 文件名检查。默认情况下,CLI 会检查 `.gbz` 和 `.hapl` 文件是否符合 GRCh38 命名习惯;CHM13 或自定义 pangenome 通常需要跳过此检查。 * * * # CHM13 (T2T) 分析示例 以下示例将展示如何在新版 `dnascope-pangenome` 中运行 CHM13 pangenome 流程。实际文件名需根据本地数据和 Sentieon 提供的资源进行替换。首先确保sentieon-cli跟model bundle都是最新版的,cli版本是 v1.6.3,model bundle 是SentieonIlluminaPangenomeRealignWGS1.2.bundle,然后命令行如下: ## 一、FASTQ 输入示例 ``` sentieon-cli dnascope-pangenome \ --reference chm13v2.0_maskedY_rCRS.fa \ --gbz hprc-v2.0-mc-chm13.gbz \ --hapl hprc-v2.0-mc-chm13.hapl \ --r1_fastq HG002_R1.fastq.gz \ --r2_fastq HG002_R2.fastq.gz \ --readgroup '@RG\tID:HG002-1\tSM:HG002\tLB:lib1\tPL:ILLUMINA' \ --pop_vcf pop-v20_chm13-20260528.vcf.gz \ -m SentieonIlluminaPangenomeRealignWGS1.2.bundle \ -t 64 \ --pcr_free \ --pangenome_ref_name CHM13 \ --pangenome_contig_prefix 'CHM13#0#' \ --skip_contig_checks \ --skip_pangenome_name_checks \ HG002.chm13.pangenome.vcf.gz ``` ## 二、BAM/CRAM 输入示例 ``` sentieon-cli dnascope-pangenome \ --reference chm13v2.0_maskedY_rCRS.fa \ --gbz hprc-v2.0-mc-chm13.gbz \ --hapl hprc-v2.0-mc-chm13.hapl \ -i HG002.chm13.sorted.cram \ --pop_vcf pop-v20_chm13-20260528.vcf.gz \ -m SentieonIlluminaPangenomeRealignWGS1.2.bundle \ -t 64 \ --pangenome_ref_name CHM13 \ --pangenome_contig_prefix 'CHM13#0#' \ --skip_contig_checks \ --skip_pangenome_name_checks \ HG002.chm13.pangenome.vcf.gz ``` ## 三、运行前检查清单 使用 CHM13 或其他非 GRCh38 参考时,建议重点检查: * `chm13.fa`、`.fai`、BED、VCF、BAM/CRAM 是否使用同一套 contig 命名。 * GBZ 文件中是否包含名为 `CHM13` 的参考路径。 * pangenome contig 前缀是否确实为 `CHM13[#0](javascript:;)#`,如果不是,应替换为实际前缀。 * population VCF 是否为 CHM13 坐标,并且与 model bundle 匹配。 * HLA/KIR、STR、segdup 等可选分析所用资源是否也与 CHM13 坐标兼容。 * * * # 可选分析模块更新 新版 `dnascope-pangenome` 支持在主流程中启用多种可选分析: ## 一、结构变异和 CNV ``` --call_svs ``` 启用后,流程会调用 Sentieon PangenomeSV 输出结构变异。如果模型 bundle 中包含 `cnv.model`,还会使用 CNVscope 输出 CNV 结果。 ## 二、重复扩增检测 ``` --expansion_catalog EXPANSION_CATALOG ``` 该参数调用 ExpansionHunter 进行短串联重复扩增检测。需要提供与参考坐标匹配的 JSON catalog。非 GRCh38 参考下不能直接复用 hg38 catalog,除非已经完成坐标转换并验证。 ## 三、片段重复区域变异检测 ``` --segdup_caller--segdup_caller CFH,CYP2D6,SMN1 ``` 不带基因名时使用默认基因集;带逗号分隔列表时,只分析指定基因。该功能依赖 `segdup-caller`,并对输入文件数量和小变异 VCF 有要求。 ## 四、HLA/KIR 分型 ``` --t1k_hla_seq T1K_HLA_SEQ --t1k_hla_coord T1K_HLA_COORD --t1k_kir_seq T1K_KIR_SEQ --t1k_kir_coord T1K_KIR_COORD ``` 在 GRCh38 中,HLA 和 KIR 有默认提取区间;如果使用 CHM13 或其他非 GRCh38 参考,应通过以下参数指定新坐标: ``` --t1k_hla_locus CHM13_HLA_INTERVAL --t1k_kir_locus CHM13_KIR_INTERVAL ``` * * * # 流程输出 以 `sample.vcf.gz` 为主输出名时,常见输出包括: |输出|说明| |--|--| |`sample.vcf.gz`|SNV 和 indel 结果| |`sample_sv.vcf.gz`|结构变异结果,仅在 `--call_svs` 启用时输出| |`sample_cnv.vcf.gz`|CNV 结果,仅在 `--call_svs` 启用且模型包含 `cnv.model` 时输出| |`` sample_bwa_deduped.cram/`.bam` ``|FASTQ 输入时的 BWA 线性比对结果| |`` sample_mm2_deduped.cram/`.bam` ``|pangenome 比对并 lift back 到参考后的结果| |`sample_metrics/`|QC 指标目录| |`` sample_metrics/`multiqc_report.html` ``|MultiQC 汇总报告| |`sample_hla/`|HLA 分型结果,可选| |`sample_kir/`|KIR 分型结果,可选| |`sample_segdups/`|片段重复区域检测结果,可选| |`` sample_expansion.vcf/`.json` ``|ExpansionHunter 输出,可选| |`sample_ploidy.json`|样本倍性和性别推断结果,在部分可选 caller 启用时输出| * * * # 总结 Sentieon DNAscope Pangenome 流程的核心价值,是将图结构参考引入短读长数据分析,在复杂区域和高多样性区域中改善比对与变异检测。本文示例以 HPRC GRCh38 pangenome 为主;新版 Sentieon CLI 明确支持 CHM13 (T2T),并为非 GRCh38 pangenome 提供了清晰参数。 对于 CHM13 分析,最关键的新增参数是: ``` --pangenome_ref_name CHM13 \ --pangenome_contig_prefix 'CHM13#0#' \ --skip_contig_checks \ --skip_pangenome_name_checks ``` 同时,必须确保参考 FASTA、pangenome graph、haplotype 文件、population VCF、BED、模型包以及可选分析资源处于同一坐标体系。对于 GRCh38 和 CHM13 之外的 Minigraph-Cactus pangenome,流程具备兼容性,但建议在正式分析前与 Sentieon 支持确认资源准备方式和参数配置。 * * * # Sentieon软件介绍 Sentieon为完整的纯软件基因变异检测二级分析方案,其分析流程完全忠于BWA、GATK、MuTect2、STAR、Minimap2、Fgbio、picard等金标准的数学模型。在匹配开源流程分析结果的前提下,大幅提升WGS、WES、Panel、UMI、ctDNA、RNA等测序数据的分析效率和检出精度,并匹配目前全部第二代、三代测序平台。 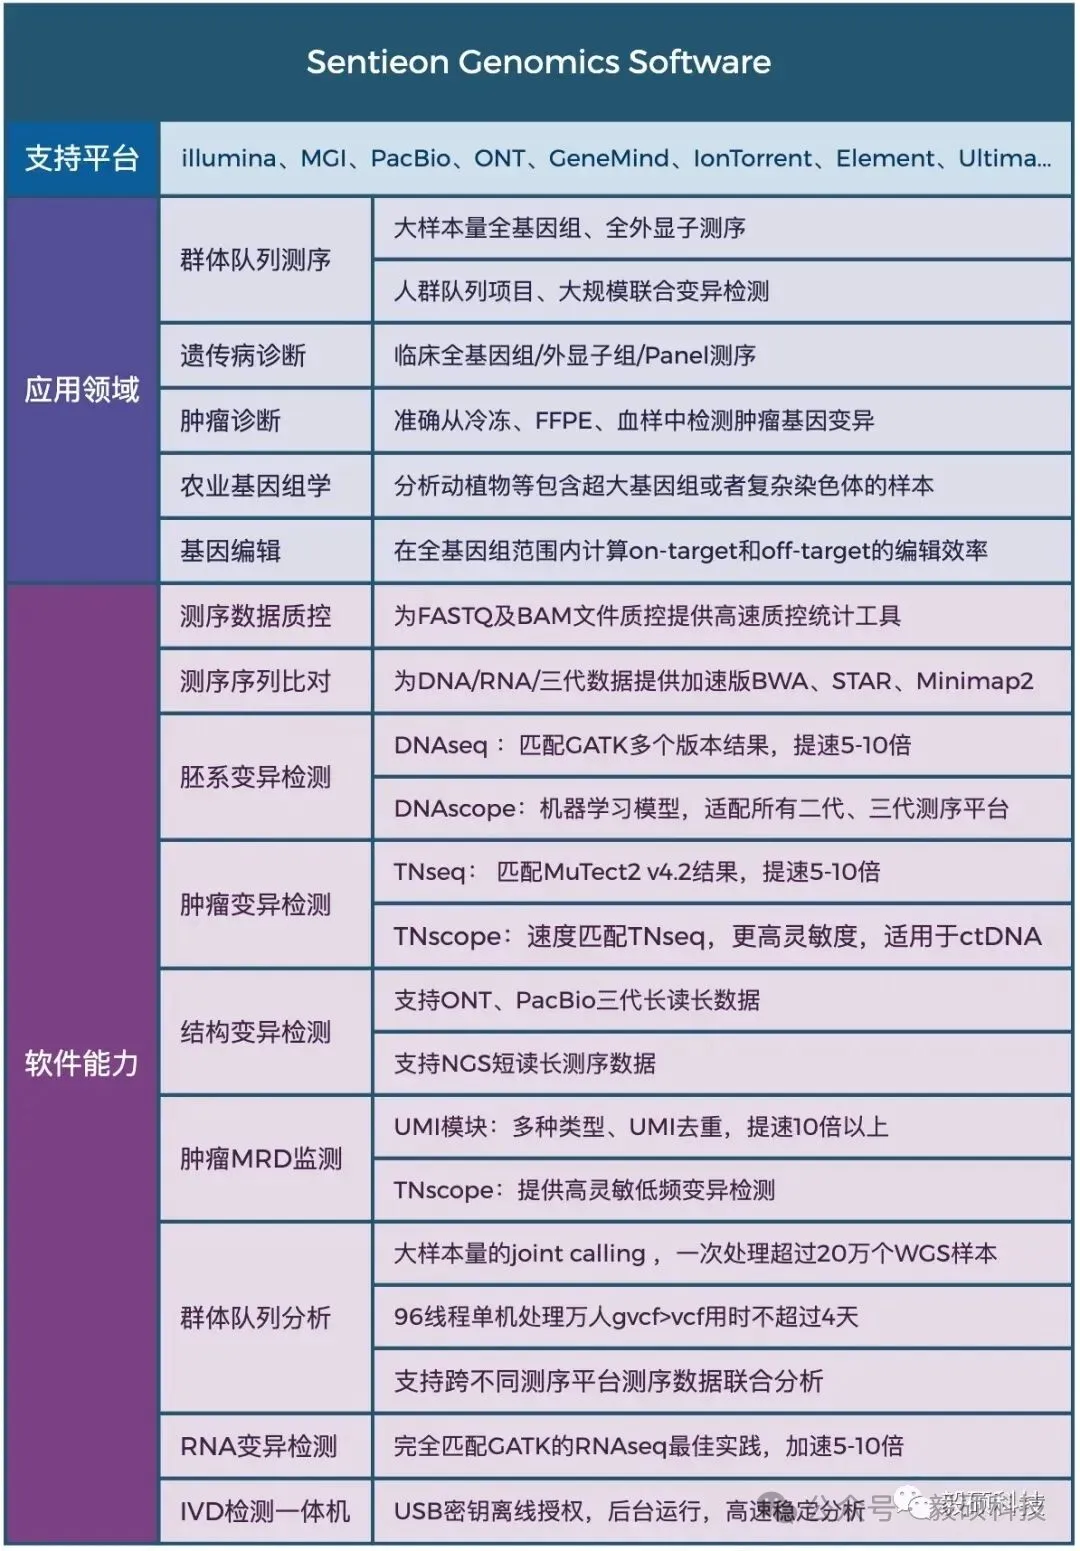 Sentieon软件团队拥有丰富的软件开发及算法优化工程经验,致力于解决生物数据分析中的速度与准确度瓶颈,为来自于分子诊断、药物研发、临床医疗、人群队列、动植物等多个领域的合作伙伴提供高效精准的软件解决方案,共同推动基因技术的发展。 截至2026年4月份,Sentieon已经在全球范围内为1860+用户提供服务,用户处理超过7400+PB数据量,被世界一级影响因子刊物如NEJM、Cell、Nature等广泛引用,引用次数超过1900篇。此外,Sentieon连续数年摘得了Precision FDA、Dream Challenges等多个权威评比的桂冠,在业内获得广泛认可。
chsnp
Aug. 27, 2026, 11:56 a.m.
Forward
Favorites
Last
Next
Scan the QR Code
Copy link
Scan the QR code to share.
Copy link
share
link
type
password
Update password
Validity period
Markdown file
Word document
PDF document (print)